




















データセンター環境の物理/仮想リソース管理のコツ(1)
実例で学ぶ、仮想リソース最適化のためのロードバランシング
IT管理者にとってデータセンター環境の適切なリソース管理は必須スキルだ。特に今後重要になるのは、仮想化された物理プラットフォームを考慮したリソースプランニングである。
今日のデータセンターは、堅牢かつ効率的であることに加え、適切に活用されることが何よりも求められる。データセンター環境のリソースがアイドル状態になると、無駄なコストが生じてしまうからだ。しかし、不適切なリソース構成でデータセンターを酷使すると、ハードウェア障害で物理ホストにトラブルが発生する危険がある。そこでIT管理者にとっては、環境全体にわたってコンピューティングリソースを管理、活用することが課題となる。これらのリソースには多くの場合、物理リソース、仮想リソース、クラウドリソースが含まれる(関連記事:システム管理ツールを制するものがデータセンター市場を制す)。
今回から3回にわたり、リソース利用を最適化する手段として、リソースプランニングと問題緩和策について解説する。また、深刻化する前に問題の芽をつみ取る方法も取り上げる。
リソースプランニングのベストプラクティス
現在のほとんどのデータセンター環境では、何らかの仮想化が導入されているか、導入される予定だ。これに伴い、仮想化された物理プラットフォームの展開を考慮することが必要になっている(関連記事:普及期に近づくも運用管理ノウハウに課題が残るサーバ仮想化)。今ではわれわれは、1台のハードウェアプラットフォームにコンピューティングリソースを依存する仮想マシン(VM)群を多数運用しているからだ。これらのリソースにはCPUやメモリ、ネットワークトラフィックのI/O(および、場合によってはディスクトラフィックのI/O)などがある。リソースの管理と問題の特定に関して言えば、プロアクティブなプランニングが適切なリソース活用に役立つ。
「リソース管理」関連記事
リソースのロードバランシング
仮想環境と物理環境のどちらを運用する場合でも、どのようなリソースが使われているか、それらのリソースがどのVMに割り当てられているかを把握することが重要だ。例えば、8コアと24GバイトのRAMを搭載する1台の物理ホストを持っている場合、エンジニアは、使用可能なリソースを全て使おうとはしないだろう。調整や障害対応の余地がなくなるからだ。
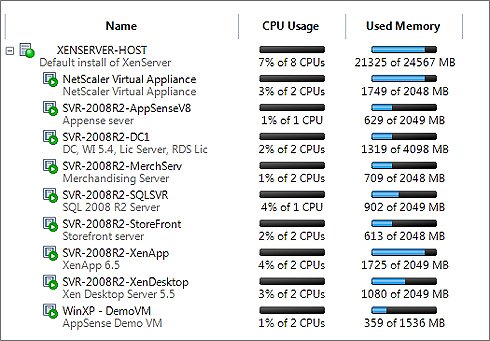 (図1)米Citrixのサーバ仮想化ソフトウェア「Citrix XenServer 6.0 Enterprise Edition」をインストールした1台のマシンが、ローカルストレージのみを使用するホストとして構成されている。小規模な環境ならこれでよいが、ビジネスの変化に伴って、より多くのホストが必要になる可能性がある
上記の例では、1台のXenServerホスト上でエンドユーザーに対して実行されているワークロードの幾つかで、リソース使用率が高くなっている。このソリューションは当面は機能するだろうが、一連のワークロードを実行している仮想サーバの負荷が急増した場合や、仮想サーバを追加する必要が生じた場合に、調整を行う余地がほとんどない。これらの場合、エンジニアは1台の物理マシン上でリソースの需要増加に対応するために、他のVMから仮想リソース(この例ではRAM)を振り向けなければならないだろう。
物理リソースは、全てのVMに必要に応じて提供されるようにしなければならない。どのような環境でも、緊急時やシステム拡張に対応する余地を残しておく必要がある。そこで出番となるのが「ロードバランシング」と「VM管理」だ。
仮想サーバと物理サーバの両方に、適切なタイプのリソースを割り当てる必要がある。リソースを大量に使用するワークロードを展開するときは、それらを実行する各VMに、リソースを計画的に提供し、他の仮想ワークロードや物理ワークロードに影響を与えないようにしなければならない。図2のように、先述のシナリオと同様のハードウェア仕様を持つセカンダリ物理ホストを追加して、物理リソース要素と仮想リソース要素のロードバランシングに着手することができる。
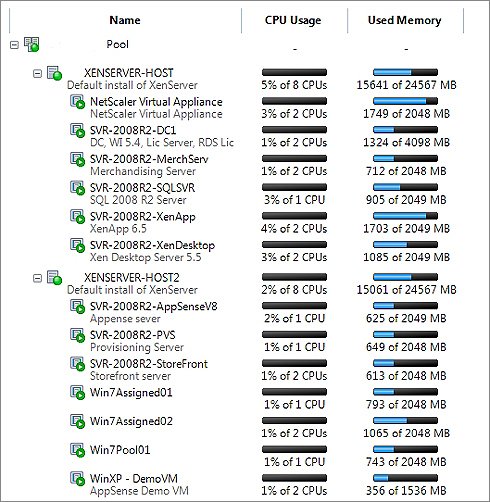 (図2)XenServer 6.0 Enterpriseでは、複数のXenServerホストで構成されるリソースプールを作成できる。このプールではリソースが共有される。実行中のVMを、SANバックボーンを介してホスト間で動的に移行できるからだ
この新しいシナリオでは、2台の物理ホストで構成されるリソースプールにおいて、VM間でリソースが共有されている。実運用される全ての環境は、どれ1つとして同じものがないため、物理リソースのロードバランシングプロセスは、ケースバイケースで個別に計画しなければならない。この例の2台の物理ホストは、既存のVMの要求に余裕を持って対応できる豊富なリソースを持っている。この環境では、VMのアジリティが保証されるようにCPUやRAM、ストレージについて高い要件が設定されている。
また、多くの環境では、高可用性(HA:High Availability)を実現するためにロードバランシングを行うことが求められる。XenServer 6.0を例に見ると、ビルトインツールがこのプロセスに役立つ。XenServerプール(XenServerで作成されたリソースプール)のHA機能を利用すれば、管理者は、あるホストから別のホストにどのVMを安全にフェイルオーバーできるかを把握できる。さらに、エンジニアは、その処理のために物理マシンごとにどれだけのリソースが必要かを判断できる。
ここで留意すべき最も重要なことは、これら2台のサーバ間でロードバランシングが行われ、VMの新規作成、フェイルオーバー、ワークフロー自動化のためにリソースが提供されることだ。HAに関しては、物理サーバの1台で障害が発生すると、もう1台がそのホストの重要なVMを引き継げる。
マシン間でリソースのロードバランシングが行われていると、VMを物理ホスト間で必要に応じて、現在のリソース状態に影響を与えずに移動できる。ディザスタリカバリ(DR)の例を考えてみよう。こうしたロードバランシングのシナリオでは、物理ホストで障害が発生した場合、VMは、リソースが見つかる別の使用可能なホストに移行される。マシンのいずれかが完全に使用されていると、DRやフェイルオーバーは不可能になる。そのサーバでは、移動してくるVMをサポートするのに使用可能なリソースがないからだ。
次回は、ワークフロー自動化やアラート監視などの管理機能を紹介しよう。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

新着ホワイトペーパー PR
-
製品資料
[株式会社MatrixFlow] 「物流リソース最適化」ガイド:人員・配車・傭車を出庫依頼の確定前に決めきる -
製品資料
[株式会社キーエンス] なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは -
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
2
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
3
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
4
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
5
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
6
【漫画付き】ひとり情シス協会が明かす、RAG導入でしくじる企業「2つの共通点」
-
7
AI時代のITインフラ戦略とは? 販売代理店が知っておきたい最新トレンド
-
8
情シスの約8割が転職や退職を意識 調査で分かった“辞めたくなる最大の理由”
-
9
人間のせいでAIエージェントの生産性が上がらない
-
10
「IBM i(AS/400)はクローズドなシステム」という誤解 DXに寄与する一歩
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
4
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
5
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
6
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
9
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー