





















ビッグデータクラスタやPolyBaseなども強化
徹底解説:SQL Server 2019で追加・強化された驚きの機能とは(1/2 ページ)
Microsoftは「SQL Server 2016」と「SQL Server 2017」をリリースした直後から、既に「SQL Server 2019」を発売する準備をしていた。そのため、同社は驚くほど多くの新機能を短期間で追加している。
 ビッグデータとの親和性も加速?
Microsoftの「SQL Server 2019」には、ビッグデータ統合の新機能、データベースエンジンの機能強化、Linuxとコンテナのサポート強化が含まれている。
ビッグデータ統合とその強化はSQL Server 2019をリリースする目的の1つだ。本稿執筆時点では、このリリースをプレビューモードで利用できる。「ビッグデータクラスタ機能」のおかげで、あらゆる場所のデータに対してクエリを実行できるようになった。その結果、利用できるプラットフォームが増加し、ビッグデータシステムとの統合を強化できる。
併せて読みたいお薦め記事
SQL Server 2019について
SQL Server on Linuxについて
- Linux版「Exchange」の開発はあるか、「SQL Server on Linux」登場で高まる期待
- SQL Server on Linuxプレビュー版公開で探るMicorosoft“オープン化”の本気度
いまさら聞けない「ビッグデータ分析」とは
それだけではない。SQL Server 2019のリレーショナルデータベース(RDB)エンジンには、パフォーマンスの向上とセキュリティの改善を実現する強化が多数加えられている。MicrosoftはWindowsで動作するSQL Serverと同等の機能を利用できるよう「SQL Server on Linux」の強化も続けている。
では、今後予定されているSQL Server 2019リリースの最も重要な新機能の一部を詳しく見ていこう。
ビッグデータクラスタで可能になるデータ仮想化
SQL Serverのビッグデータクラスタ機能により、ビッグデータソースとの密接な統合が可能になった。その結果、新たにデータ仮想化機能が利用できる。SQL Server 2019のビッグデータクラスタは「PolyBase機能」を活用することでデータ仮想化を実現する。データ仮想化とは、データの移動やコピーをせずに多数のソースのデータを組み合わせることを指す。
昨今の企業は一般的に、リレーショナルと非リレーショナルを組み合わせたさまざまな種類のデータを使用している。このため通常はリレーショナルデータソースと非リレーショナル(ここではビッグデータソースの意味)の両方のデータを組み合わせる必要がある。最も価値の高い企業データはSQL Serverのようなリレーショナルデータベースに保存する。IoTデータのようなビッグデータソースは主に「Hadoop Distributed File System」(HDFS)などの分散ファイルシステムに保存する。
この2種類のデータの組み合わせが求められることは多い。Extract(抽出)、Transform(変換)、Load(読み込み)というプロセス(ETLプロセス)を用いて、単一のプラットフォームにデータをコピーし、そこでレポートや分析を実行するのが一般的だ。こうしたプロセスはバッチ処理指向であるため、実行に時間がかかり、大量のストレージが必要になる。
SQL Server 2019のビッグデータクラスタには、PolyBase機能がある。この機能を使ってデータのレプリケート(複写)や移動なしで複数のデータソースのデータをまとめる。価値の高いリレーショナルデータとビッグデータを1つのクエリで組み合わせるのが基本だ。その際に、ETLプロセスを実行したり余計なストレージを使用したりする必要はない。この仕組みを実現するために、SQL Server 2019のデータベースエンジンはHDFSファイルをネイティブに読み取れるようになっている。
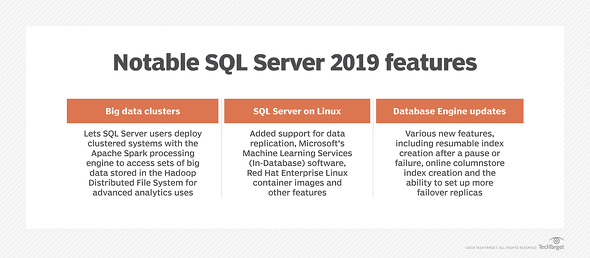 図1 SQL Server 2019で最も期待される3つの分野の新機能
SQL Server 2019のビッグデータクラスタは多数の異なるテクノロジーをベースに構築されている。例えば、「Docker」(SQL Server on Linuxで利用)「Apache Spark」「Apache Hadoop」「Kubernetes」などがベースになる。SQL Server 2019のビッグデータクラスタを使用することで、ユーザーはSQL Serverコンテナで構成されたスケーラブル(拡張可能)なクラスタをKubernetesに導入できる。これらのコンテナでは「Transact-SQL」を使用してビッグデータの読み取り、書き込み、処理ができる。
SQL Server 2019のビッグデータクラスタの大まかな概要を図2に示す。この図から、ビッグデータクラスタがSQL ServerコンテナとSpark Linuxコンテナから構成され、コンテナ管理とオーケストレーションにKubernetesが使われていることが分かるだろう。Dockerコンテナはコンピューティング層を構成するノードのグループ上で実行され、クエリはこれらの複数のDockerコンテナ全体で並列処理される。高度な分析や機械学習はSparkを使って実行可能だ。ビッグデータクラスタのアクティビティーはSQL Serverの「マスターインスタンス」が管理する。
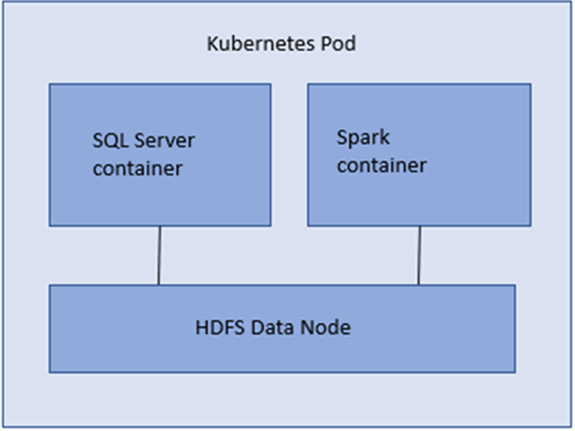 図2 SQL Server 2019のビッグデータクラスタの大まかな概要
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
プレミアムコンテンツ
[アイティメディア株式会社] AI活用を成功に導く「オブジェクトストレージ」 NAS/SANの限界を突破するには -
プレミアムコンテンツ
[アイティメディア株式会社] 「性能ならSSD」「大容量ならHDD」はもう古い? 変わるストレージの常識 -
プレミアムコンテンツ
[アイティメディア株式会社] 「オンプレミス回帰」がまさかの失敗に クラウドをやめずに安くする最適化手法 -
事例
[発注ナビ株式会社] AI活用を成功させる企業とそうでない企業の違いとは? -
製品レビュー
[発注ナビ株式会社] システム開発「はじめの一歩」 押さえておきたい基礎知識と失敗を防ぐ方法
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「GPT-6.1 Terra」は半額 それでもなぜ企業はAIモデルを選べないのか?
-
2
テレビとノートPCをつないだのに映らない――Dellが解説する正しい接続方法
-
3
AIに長文を入力する際の「コンテキストウィンドウ」の適切な扱い方はどれ?
-
4
「仮想化基盤の更改とコスト最適化」に関するアンケート
-
5
「Microsoft 365」が乗っ取られる MFAを破る“本物の画面”の恐怖
-
6
SAP移行で1900億円の赤字 「ベンダー任せ」が招くERP崩壊と回避策
-
7
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
8
Java SEに「Java4Shell」、WebLogicも修正――今朝の情シスニュース
-
9
なぜ「Claude Code」拡張は消しても危ないのか? Cursorで不正版配信
-
10
Outlookでゼロデイ悪用、ChromeはXSLT停止――今朝の情シスニュース
ホワイトペーパーランキング PR
-
1
「IT史に名を残すシステム障害」8選
-
2
SCS評価制度時代の「SASE選定」ガイド
-
3
Microsoft 365 Copilotを安全&効果的に活用するために必要な「2つの準備」
-
4
パスワード管理だけで十分? 特権アクセスを脅かす暗号鍵の放置リスクとは
-
5
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
6
すぐ分かる「AWS WAF」ガイド:特徴・運用課題・メリットを解説
-
7
マンガで解説:情シスの負担を減らす「MDRサービスのインシデント対応」の中身
-
8
「Copilot Cowork」でこう変わる AIエージェント時代の新たな働き方とは
-
9
AI活用で激化する外部・内部リスク、取引先へ波及する脅威から守る対策とは?
-
10
「AIエージェント」は業務でどう役立つのか? 現場で進む活用例“10選”
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー