




















AI-readyなデータ基盤の現実解
生データをAIに渡すな デジタル庁が明かすMCP×意味定義の実践知
AIに生データを渡すだけでは誤集計は防げない。デジタル庁が約7.5万件のデータで検証した、MCPと意味定義層でLLMの誤読を抑え込む「AI-ready」な設計思想と実装手法を解剖する。
社内データを生成AIに渡して分析させようとしたものの、計算ミスや項目の取り違えが多発し、結局人間がExcelで検算し直す羽目になった経験はないだろうか。デジタル庁は2026年8月13日、国の行政手続などについての調査データ約7万5000件を対象に、対話形式の自然言語で分析できる検証用実装をGitHubで公開した。
AIに生データを直接渡さず、LLMには検索条件の指定のみを担わせて計算を外部サーバ側で処理する構成を採った。以下では、データの誤読や不適切な集計を抑え込むための意味定義層と品質管理の仕組みを解剖する。
生データを渡さずサーバ側で集計を実行
今回の検証で対象としたのは、デジタル庁が公表する国の法令などに基づく行政手続などのオンライン化状況などをまとめた調査データ(38列、約7万5000件)だ。事業者が直面する手続の電子化状況や、引越し・結婚・法人設立といったライフイベント横断の手続件数を自然言語で検索・集計できる。
最大の特徴は、生データをLLMに直接読み込ませるのではなく、外部連携の標準規格である「MCP(Model Context Protocol)」を採用した点にある。LLMの役割を検索や集計の条件指定にとどめ、算術処理はMCPサーバ側で完結させるアーキテクチャを採用した。これにより、LLM特有の計算ミスやコード値の誤用を防いでいる。
データの格納形式にはCSVではなく列指向の圧縮バイナリ形式である「Apache Parquet」を採用。約7万5000行、39列の調査データが約3MBに圧縮される。Parquetファイルの末尾に含まれるメタデータのみをサーバ起動時に読み込み、実データはクエリ実行時に初めてメモリへロードする遅延ロードによって省メモリ化を図っている。
国際標準SDMXを参考にした意味定義と品質把握
生データをMCP経由でAIに提供するだけでは、欠損値の扱いや指標の解釈ミスを防ぎきれない。そこで同実装では、統計データの国際標準規格「SDMX」のデータ構造定義(DSD)の考え方を参考に、独自形式の設定ファイル「dataset.yaml」を用意した。
この設定ファイルでは、分析の軸となる分類項目(dim)、数値項目(measure)、サーバ側で算出する指標(computed_measures)を定義している。例えば「オンライン手続件数」の欠損値(null)は「0件」ではなく「件数不明」を意味するといった解釈上の注意(notes)を付与し、AIが誤った推測で数値を引用しないよう制御している。
データの探索から分析までは、役割を分けた4つのMCPツールで実行する。データセットの存在を確認する「list_datasets」と構造を把握する「inspect_dataset」の探索層ツールを経て、実データの取得を行う「query_records」および「summarize_records」を呼び出す。inspect_datasetは設定ファイルの定義に加え、実データから充填率や数値統計を動的に算出してAIに返す仕様とした。
ユーザーインタフェースには、チャットUI内にグラフや表を直接表示できる拡張仕様「MCP Apps」を試作した。集計軸の数に応じて、円グラフ、棒グラフ、ヒートマップ、ツリーマップなどを自動で切り替えて描画できる。
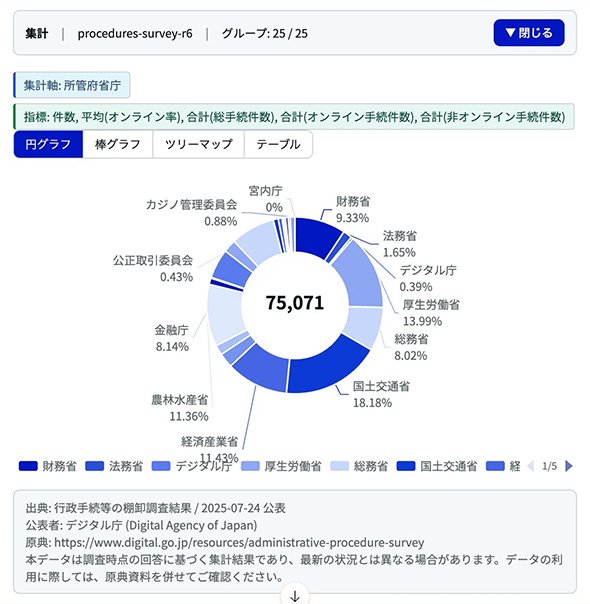 所管府省庁別の手続件数を円グラフで表示(画像出典:デジタル庁)
型揺れや漢字の誤読を吸収する対話向け設計
LLMがツールを呼び出す際に発生する入力の揺れでも、サーバ側で多層的な保護策を講じた。
LLMがツール引数を辞書形式で送るかJSON文字列で送るかが一定しない問題では、複数の入力形式を正規化して受け入れる処理を実装した。また、LLMが似た漢字を混同して出力する現象では、完全一致、Unicode NFKC正規化、ライブラリによる近似一致の3段階で項目名を照合する。近似一致はフィールド名という閉じた語彙(ごい)に限定し、誤補正を防ぐガードを設けた。
さらに、ツール応答を辞書の配列形式から列指向形式へ変換することで、キー名の繰り返しを排除し、消費トークン数の削減も図っている。
同実装はGitHubのリポジトリ「administrative-procedures-mcp」で公開されており、Python 3.10以上の環境で検証できる。また、ブラウザの内蔵AIを利用し、APIキーなしでローカル環境のみで動作を確認できるプレビュー機能も備えている。
Copyright © ITmedia, Inc. All Rights Reserved.


TechTarget ニュースプラス
国内のIT業界ニュースを迅速に報道します。企業動向から導入事例、市場トレンドまで幅広く取り上げ、実務に直結する情報をタイムリーに提供する連載です。
関連記事
新着ホワイトペーパー PR
-
製品資料
[NTTインテグレーション株式会社] 取引先のセキュリティをどう管理する? 「SCS評価制度」対応の勘所を解説 -
製品資料
[NTTインテグレーション株式会社] SCS評価制度「★4」取得のカギ 最大の壁を突破する方法とは? -
製品資料
[NTTインテグレーション株式会社] 2026年度末から運用開始 「SCS評価制度」に備えて製造業がやるべきことは? -
事例
[ネットワンパートナーズ株式会社, アイビーシー株式会社] ハイブリッド環境の一元管理と快適な無線LAN環境、三井ホームはどう実現した? -
市場調査・トレンド
[TD SYNNEX株式会社] 調査で学ぶセキュリティ運用の実態 人を増やさず品質を維持する方法とは?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
2
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
3
LINEヤフーはなぜ「社内の管理者」すら信用しないインフラを作ったのか
-
4
1200万円のSaaS導入を回避 スギ薬局「運用費10万円」のAIエージェント構築術
-
5
IBM iのブラックボックス化を打破 資産継承と進化を実現する「IBM Bob」の実力
-
6
2027年電子帳簿保存法のさらなる改正 安易なシステム導入の落とし穴
-
7
「Microsoft 365」が乗っ取られる 跡形もなくMFAを破る手口
-
8
「高収入エンジニア」になれる“大人気の副業”7選
-
9
「RAGの利用」に関するアンケート
-
10
AIインフラの理想形? 「5層のケーキ」を垂直統合するための近道とは
ホワイトペーパーランキング PR
-
1
DX/AI投資の壁を突破、現代の最高財務責任者が直面する課題と克服のヒント
-
2
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
3
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
4
バックアップは“取っているから大丈夫”なのか? ランサムウェア時代の備え方
-
5
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
6
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
7
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
8
ネットワーク遅延の原因、「パケットロス」の基礎知識と効果的な解決策
-
9
5分で分かる Microsoft 365のデータ損失に備えるためのバックアップの仕組み
-
10
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー