




















ビッグデータクラスタやPolyBaseなども強化
徹底解説:SQL Server 2019で追加・強化された驚きの機能とは(1/2 ページ)
Microsoftは「SQL Server 2016」と「SQL Server 2017」をリリースした直後から、既に「SQL Server 2019」を発売する準備をしていた。そのため、同社は驚くほど多くの新機能を短期間で追加している。
 ビッグデータとの親和性も加速?
Microsoftの「SQL Server 2019」には、ビッグデータ統合の新機能、データベースエンジンの機能強化、Linuxとコンテナのサポート強化が含まれている。
ビッグデータ統合とその強化はSQL Server 2019をリリースする目的の1つだ。本稿執筆時点では、このリリースをプレビューモードで利用できる。「ビッグデータクラスタ機能」のおかげで、あらゆる場所のデータに対してクエリを実行できるようになった。その結果、利用できるプラットフォームが増加し、ビッグデータシステムとの統合を強化できる。
併せて読みたいお薦め記事
SQL Server 2019について
SQL Server on Linuxについて
- Linux版「Exchange」の開発はあるか、「SQL Server on Linux」登場で高まる期待
- SQL Server on Linuxプレビュー版公開で探るMicorosoft“オープン化”の本気度
いまさら聞けない「ビッグデータ分析」とは
それだけではない。SQL Server 2019のリレーショナルデータベース(RDB)エンジンには、パフォーマンスの向上とセキュリティの改善を実現する強化が多数加えられている。MicrosoftはWindowsで動作するSQL Serverと同等の機能を利用できるよう「SQL Server on Linux」の強化も続けている。
では、今後予定されているSQL Server 2019リリースの最も重要な新機能の一部を詳しく見ていこう。
ビッグデータクラスタで可能になるデータ仮想化
SQL Serverのビッグデータクラスタ機能により、ビッグデータソースとの密接な統合が可能になった。その結果、新たにデータ仮想化機能が利用できる。SQL Server 2019のビッグデータクラスタは「PolyBase機能」を活用することでデータ仮想化を実現する。データ仮想化とは、データの移動やコピーをせずに多数のソースのデータを組み合わせることを指す。
昨今の企業は一般的に、リレーショナルと非リレーショナルを組み合わせたさまざまな種類のデータを使用している。このため通常はリレーショナルデータソースと非リレーショナル(ここではビッグデータソースの意味)の両方のデータを組み合わせる必要がある。最も価値の高い企業データはSQL Serverのようなリレーショナルデータベースに保存する。IoTデータのようなビッグデータソースは主に「Hadoop Distributed File System」(HDFS)などの分散ファイルシステムに保存する。
この2種類のデータの組み合わせが求められることは多い。Extract(抽出)、Transform(変換)、Load(読み込み)というプロセス(ETLプロセス)を用いて、単一のプラットフォームにデータをコピーし、そこでレポートや分析を実行するのが一般的だ。こうしたプロセスはバッチ処理指向であるため、実行に時間がかかり、大量のストレージが必要になる。
SQL Server 2019のビッグデータクラスタには、PolyBase機能がある。この機能を使ってデータのレプリケート(複写)や移動なしで複数のデータソースのデータをまとめる。価値の高いリレーショナルデータとビッグデータを1つのクエリで組み合わせるのが基本だ。その際に、ETLプロセスを実行したり余計なストレージを使用したりする必要はない。この仕組みを実現するために、SQL Server 2019のデータベースエンジンはHDFSファイルをネイティブに読み取れるようになっている。
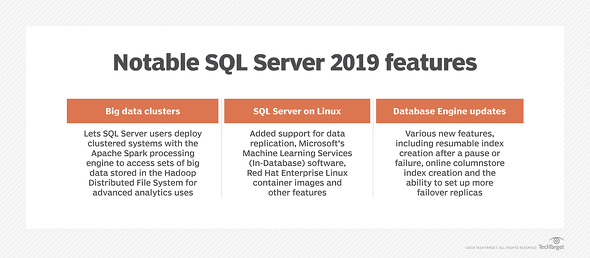 図1 SQL Server 2019で最も期待される3つの分野の新機能
SQL Server 2019のビッグデータクラスタは多数の異なるテクノロジーをベースに構築されている。例えば、「Docker」(SQL Server on Linuxで利用)「Apache Spark」「Apache Hadoop」「Kubernetes」などがベースになる。SQL Server 2019のビッグデータクラスタを使用することで、ユーザーはSQL Serverコンテナで構成されたスケーラブル(拡張可能)なクラスタをKubernetesに導入できる。これらのコンテナでは「Transact-SQL」を使用してビッグデータの読み取り、書き込み、処理ができる。
SQL Server 2019のビッグデータクラスタの大まかな概要を図2に示す。この図から、ビッグデータクラスタがSQL ServerコンテナとSpark Linuxコンテナから構成され、コンテナ管理とオーケストレーションにKubernetesが使われていることが分かるだろう。Dockerコンテナはコンピューティング層を構成するノードのグループ上で実行され、クエリはこれらの複数のDockerコンテナ全体で並列処理される。高度な分析や機械学習はSparkを使って実行可能だ。ビッグデータクラスタのアクティビティーはSQL Serverの「マスターインスタンス」が管理する。
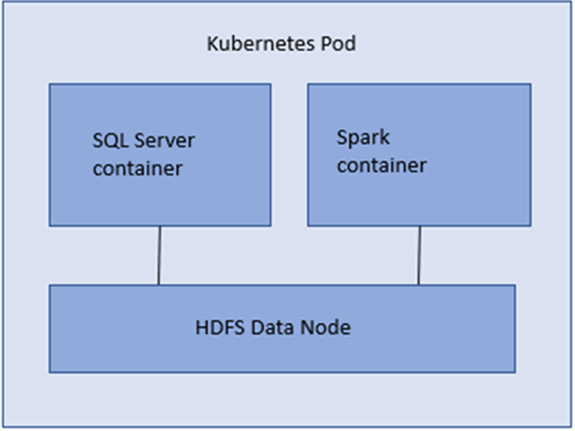 図2 SQL Server 2019のビッグデータクラスタの大まかな概要
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社MatrixFlow] 「物流リソース最適化」ガイド:人員・配車・傭車を出庫依頼の確定前に決めきる -
製品資料
[株式会社キーエンス] なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは -
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
2
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
3
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
4
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
5
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
6
情シスの約8割が転職や退職を意識 調査で分かった“辞めたくなる最大の理由”
-
7
「結局使わなくなる」Microsoft 365 Copilotを半年で定着 キリンの3施策
-
8
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
9
「中堅・中小企業のネットワーク・セキュリティ運用実態」に関するアンケート
-
10
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
4
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
5
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
6
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
9
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー