





















スモールスタートから重要なビジネス基盤への成長
「モンスト」の裏側を支えるログ分析システムを、ミクシィはどのように構築したか(1/2 ページ)
ゲーム「モンスターストライク」(モンスト)で躍進するミクシィのデータ分析基盤を支えたのは、新しいワークスタイルだった。たった数人から始まったチームが全社を支える一大プロジェクトまで育った背景とは。
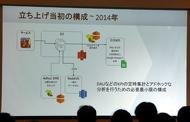 立ち上げ当初のログ分析システム概略図《クリックで拡大》
気軽にプレイできるスマートフォンゲームには、オンライン対戦やフレンドとの連携プレイが可能なゲームも少なくない。プレイの気軽さに反して、リアルタイムに近いデータ処理など、バックエンドの処理能力への要求レベルは高い。スマートフォンゲームにおいては、ゲームプレイそのものを支えるシステムでなくても「リアルタイム性」は重視されているようだ。人気スマートフォンゲーム「モンスターストライク」(モンスト)を開発するミクシィのXFLAGスタジオでは、同タイトルなどのログデータ分析を準リアルタイムで処理できる環境を構築した。
ミクシィのXFLAGスタジオはモンストシリーズや「ファイトリーグ」など、家族や友達と楽しめる数々の対戦型ゲームを提供している。中でもモンストはiOSのApp Storeトップ無料ランキング「BEST OF 2017」にノミネートしたり、AndroidのGoogle Play5周年インストールランキング(2017年3月発表)におけるゲーム部門の2位を受賞したりするほどのヒットタイトルだ。リリースから5年近くたった今も多くのプレイヤーを魅了し、世界累計利用者数は4500万人に上る(2018年3月時点)。
ゲームを運営する基盤に求められるのは、人気の盛衰に合わせて自由に、短時間にスケールできることだ。その要望に見合うインフラ基盤として、AWSをはじめとするクラウドの利用も進んでいる。
ミクシィのXFLAGスタジオはモンストのログ管理にもAWSを利用している。小さく簡易的なシステムからスタートし、ゲームプレイヤーが増えるに従ってシステムを拡張、現在では目的別に何種類ものダッシュボードを用意して必要なデータをすぐに得られる高度なシステムに成長させている。そこで扱われるデータ量は、毎日2TB。これまでに蓄積したデータは約1PBにもなる。このログ分析システムは、ゲームリリース当初の2014年時点では、ごくシンプルな仕組みだった。
併せて読みたいお薦め記事
AWS Summit Tokyo 2018レポート
- 東京電力FPが発電所監視サービスをAWSで開発 7億円以上のコスト削減
- ナビタイムが全サービスをAWS移行 アンチパターンてんこ盛りでGPUは生かせるか
- DeNAが「AWS IoT」を使った配車サービスの裏側を公開
- 金融機関がAWSでクラウド化 セキュリティ対策とコスト管理を両立させるには
クラウド活用でコストを削減する
日次バッチ処理に15時間かかる基本形からスタートし、改良を重ねたログ管理基盤
 ミクシィXFLAGスタジオの生島 光氏
AWSの年次カンファレンス「AWS Summit Tokyo 2018」において、ミクシィXFLAGスタジオでモンスト事業本部解析グループの生島 光氏は「2014年当時はサーバで発生したログを『Amazon Simple Storage Service』(Amazon S3)に保存し、そのログを使って分析をしていました。必要に応じてアドホックな分析もできるよう、『Apache Hadoop』のマネージドサービスである『Amazon Elastic MapReduce』(Amazon EMR)をスポットインスタンスとして用意していましたが、それだけでは補えない課題も幾つか抱えていました」と当時を振り返る。
課題は運用面、データ活用面の双方に及んでいた。運用面では、Amazon EMRの起動やデータウェアハウス構築環境「Apache Hive」(Hadoopで動作するMapReduceアプリケーション)の処理に時間がかかっていたことが挙げられる。アドホックな分析のたびにAmazon EMRを起動していたが、その都度メタ情報を再構築していたため起動に30分ほど要していた。そこでApache Hiveのメタストア(テーブルやロールなどのメタデータ)を「Amazon Relational Database Service」(Amazon RDS)に格納して永続化し、Amazon EMR起動時にはこれを読み込むだけの仕様に変更したところ、5分程度でAmazon EMRが起動するようになった。他にも、日次処理に利用していたApache Hiveの処理速度にも問題があった。日次処理に15時間ほどかかっており、終業時にバッチ処理をスタートしても翌昼まで処理が終わらない状況だったという。
そこで生島氏は、次のような方法で解決を図った。全てのデータをORC(注1)に変換し、新たに追加されるデータもORCに変換する処理をバッチに追加。「Apache TEZ」を実行エンジンとするなど定番のチューニングも施し、Dynamic Partition機能でデータを分割することで、処理時にスキャンするデータ量も削減した。直列実行ではリソースを使い切れていなかったので、自社開発したジョブフローツールでタスク依存関係に沿ってバッチ処理の順序を最適化し、並列処理ができるものは並列処理するようにしたという。「日次バッチ処理の高速化は、幾つもの技術を複合的に使い実現しました」(生島氏)
※注1 ORC(Optimized Row Columnar)ファイル。Hiveに最適化されたカラム志向型のデータフォーマット。
こうした進化を経て現在は、AWSサーバプラン「m4.2xlarge」20台で構成したAmazon EMRと、3台の「ds2.8xlarge」、データウェアハウスサービス「Amazon RedShift」を利用して24TBのストレージでログ管理基盤を構成している。Amazon EMRはマスターインスタンスグループもコアインスタンスグループも、スポットインスタンスとして用意し、必要なときのみ起動する仕様だ。2014年から2015年にかけて、これらの基盤を整備した結果、日次バッチ処理にかかる時間は15時間から9時間まで短縮されたそうだ。終業時にスタートすれば、翌朝の業務開始までに終わる時間に収まったわけだ。
データ利活用のハードルを下げるために重ねた工夫
データ活用面における最初の課題は、ログ分析の手段を持つ人間がエンジニアに限られていたことだ。理由は単純で、Amazon S3に蓄積したログにアクセスするため、SSH で接続する必要があったのだ。コマンドラインインタフェース(CLI)を使いこなせるエンジニアにしかログ分析の手段がなく、ゲーム運営の現場でデータ活用することは難しかった。これを解決するために、同社は幾つかのビジネスインテリジェンス(BI)ツールを導入した。
「BIツールは目的に応じて市販製品を数種類、使い分けています。いずれも公式のDockerイメージを使ってAWSで利用しています。障害が発生しても自動的に再起動してくれるので、運用に手間がかからないのがポイントです。市販製品だけではカバーできない独自の分析については、内製ツールも併用しています」(生島氏)
こうしたアクセス経路の整備により、データを分析して活用する道は開けたものの、手軽ではなかった点が課題として残っていた。取り扱っているのがサーバから書き出された生ログデータなので、目的に合わせて分析するためには複雑なクエリを記述しなければならなかったのだ。
「例えば『ゲームプレイヤーがオンラインでマルチプレイをしたかどうかを知りたい』というだけでも、数十行のクエリを書かなければなりませんでした。しかもそのためには、アプリ開発者視点で作られたログテーブルの意味を理解しなければなりません」(生島氏)
これを解決するために、生島氏のチームは分析用のテーブルを新たに用意した。頻繁に検索されるデータを、現場目線でも分かりやすいテーブル名で提供することで、データ活用のハードルを下げたのだ。先述のマルチプレイの例で言えば、「is_multi」という分かりやすい名前のカラムが追加され、簡単なクエリでマルチプレイを楽しんだプレイヤーのデータを抽出できるようにした。「アプリ開発者ではなくデータ分析者の視点に立ったテーブル整備には、『Dimension Modeling』という考え方が役立った」と生島氏は言う。
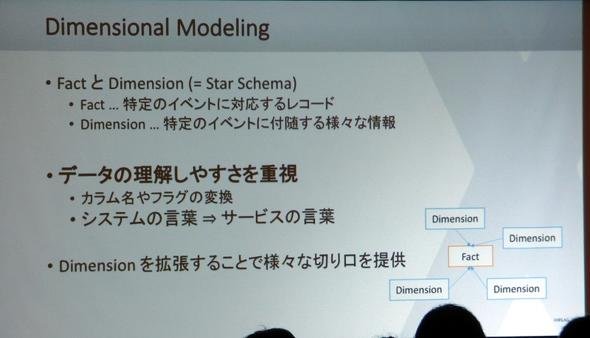 分析しやすいようDimension Modelingという手法でデータを再設計《クリックで拡大》
「Dimension Modelingは、理解しやすさを重視したデータモデル化の手法です。システムの言葉を、サービスに即した言葉に置き換えていきます。アプリが書き出したファクトに対して、さまざまな切り口(Dimension)を持たせたテーブルを用意して分析スピードを向上させます」(生島氏)
データ利用のハードルが下がったことで、生島氏が所属するデータ分析チーム以外のメンバーにもデータ活用が広まっていった。そこで新たな課題として浮上したのが、データの信頼性をどのように担保するかということだ。データ分析チームのメンバーやアプリ開発に携わるエンジニアであれば、異常なデータの「違和感」を経験から察知できる。しかしデータ活用が広まれば広まるほど、利用者のITリテラシーは幅広くなり、データを盲信するユーザーも多くなる。誤ったデータに基づいた分析にならないよう、データの信頼性にはこれまで以上に気を配る必要があった。
「そもそもの前提として、データは壊れるものです。変換処理、通信エラー、バックアップのためのコピーなどの原因によって、データは壊れます。事前のテストで防ぐこともできません。代わりに、データが壊れていないかどうか判別できる仕組みを組み込みました」(生島氏)
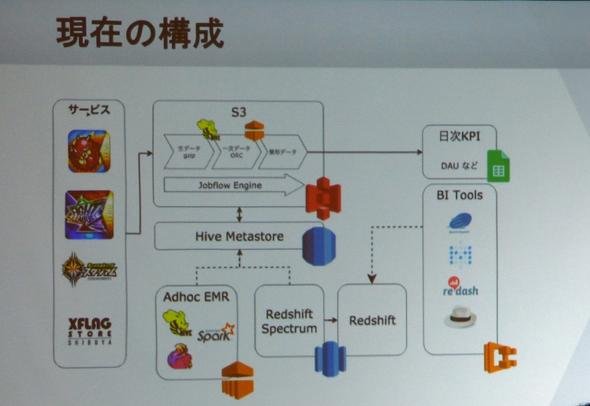 現在のログ管理基盤構成《クリックで拡大》
具体的にはバッチ処理の後半で、データ品質チェックを実行しているという。異なるデータソースでの比較、変換前後の比較、意図しないNULLカラムの検出などによって、データが壊れていないかどうかチェックしている。こうした施策によりエンジニア以外のメンバーも手軽に、しかも安心してデータを分析、活用できるようになった。現在ではデータ分析専任チームの5人に加えて、各サービス担当者約200人がデータにアクセスしている。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
技術文書・技術解説
[SAS Institute Japan株式会社] 生成AIを予知保全に組み込むことで「産業設備保全」はどこまで進化できるのか -
市場調査・トレンド
[SAS Institute Japan株式会社] 製造企業が「AIによる価値創出」を迅速に実現する方法 -
技術文書・技術解説
[株式会社日立ソリューションズ] 開発と運用の分断を解消、実践知に基づくプラットフォームエンジニアリングとは -
事例
[株式会社日立ソリューションズ] 開発・運用の属人化をどう打破した? 日立ソリューションズの実践事例 -
技術文書・技術解説
[Eleven Labs Japan合同会社] 問い合わせ解決単価を約9割削減する試算も 音声AIエージェントのROIと活用例
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
なぜMicrosoftは「Rust」を標準言語に? AIで進むC/C++書き換えの課題
-
2
なぜ「Claude Code」拡張は消しても危ないのか? Cursorで不正版配信
-
3
8割がアナログに逆戻りする“やっぱりな理由” DXを阻む2つの落とし穴
-
4
Microsoft 365統一で「SharePoint」が1日2TB増 富士フイルムはどう管理した?
-
5
毎日2時間の“無駄”を生む「紙とExcel」管理 田中精密工業はどう脱却したのか
-
6
なぜ「WSUS」を捨てない? 非推奨でも35%が使い続けるワケ
-
7
なぜ「Microsoft Teams」がランサムウェアの入り口になるのか?
-
8
不正アクセス相談が37%→57%に 攻撃者から自社のシステムはどう見えているか
-
9
なぜストレージ不足は長引くのか? 77%が「12〜18カ月続く」と予測
-
10
ログインの「3回に1回は高リスク」 MFAだけでは防げない「正規認証」の悪用
ホワイトペーパーランキング PR
-
1
「IT史に名を残すシステム障害」8選
-
2
AIが苦手な「汚いデータ」になっていない? AI投資を無駄にしないための注意点
-
3
急増する高度なフィッシング詐欺 先回りしてブロックするには何が必要?
-
4
法人向け光回線のプランはどう選ぶ? 機能面/保守体制/コストを一覧で比較
-
5
「テスト内製化&自動化」事例集:ディー・エヌ・エーなど9社に学ぶ実践のコツ
-
6
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
7
有識者が語る、中堅中小企業に求められる最新のサイバーセキュリティ対策とは
-
8
10G回線の真価をフルに享受するには? 導入前にチェックしたいポイント
-
9
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
10
進化が遅れる「電話」をアップデート、AIを搭載した次世代の通話機能とは?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー