




















データセンター環境の物理/仮想リソース管理のコツ(1)
実例で学ぶ、仮想リソース最適化のためのロードバランシング
IT管理者にとってデータセンター環境の適切なリソース管理は必須スキルだ。特に今後重要になるのは、仮想化された物理プラットフォームを考慮したリソースプランニングである。
今日のデータセンターは、堅牢かつ効率的であることに加え、適切に活用されることが何よりも求められる。データセンター環境のリソースがアイドル状態になると、無駄なコストが生じてしまうからだ。しかし、不適切なリソース構成でデータセンターを酷使すると、ハードウェア障害で物理ホストにトラブルが発生する危険がある。そこでIT管理者にとっては、環境全体にわたってコンピューティングリソースを管理、活用することが課題となる。これらのリソースには多くの場合、物理リソース、仮想リソース、クラウドリソースが含まれる(関連記事:システム管理ツールを制するものがデータセンター市場を制す)。
今回から3回にわたり、リソース利用を最適化する手段として、リソースプランニングと問題緩和策について解説する。また、深刻化する前に問題の芽をつみ取る方法も取り上げる。
リソースプランニングのベストプラクティス
現在のほとんどのデータセンター環境では、何らかの仮想化が導入されているか、導入される予定だ。これに伴い、仮想化された物理プラットフォームの展開を考慮することが必要になっている(関連記事:普及期に近づくも運用管理ノウハウに課題が残るサーバ仮想化)。今ではわれわれは、1台のハードウェアプラットフォームにコンピューティングリソースを依存する仮想マシン(VM)群を多数運用しているからだ。これらのリソースにはCPUやメモリ、ネットワークトラフィックのI/O(および、場合によってはディスクトラフィックのI/O)などがある。リソースの管理と問題の特定に関して言えば、プロアクティブなプランニングが適切なリソース活用に役立つ。
「リソース管理」関連記事
リソースのロードバランシング
仮想環境と物理環境のどちらを運用する場合でも、どのようなリソースが使われているか、それらのリソースがどのVMに割り当てられているかを把握することが重要だ。例えば、8コアと24GバイトのRAMを搭載する1台の物理ホストを持っている場合、エンジニアは、使用可能なリソースを全て使おうとはしないだろう。調整や障害対応の余地がなくなるからだ。
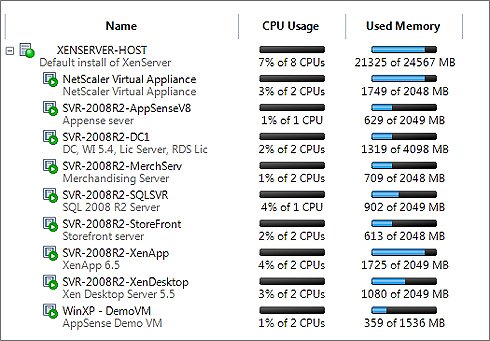 (図1)米Citrixのサーバ仮想化ソフトウェア「Citrix XenServer 6.0 Enterprise Edition」をインストールした1台のマシンが、ローカルストレージのみを使用するホストとして構成されている。小規模な環境ならこれでよいが、ビジネスの変化に伴って、より多くのホストが必要になる可能性がある
上記の例では、1台のXenServerホスト上でエンドユーザーに対して実行されているワークロードの幾つかで、リソース使用率が高くなっている。このソリューションは当面は機能するだろうが、一連のワークロードを実行している仮想サーバの負荷が急増した場合や、仮想サーバを追加する必要が生じた場合に、調整を行う余地がほとんどない。これらの場合、エンジニアは1台の物理マシン上でリソースの需要増加に対応するために、他のVMから仮想リソース(この例ではRAM)を振り向けなければならないだろう。
物理リソースは、全てのVMに必要に応じて提供されるようにしなければならない。どのような環境でも、緊急時やシステム拡張に対応する余地を残しておく必要がある。そこで出番となるのが「ロードバランシング」と「VM管理」だ。
仮想サーバと物理サーバの両方に、適切なタイプのリソースを割り当てる必要がある。リソースを大量に使用するワークロードを展開するときは、それらを実行する各VMに、リソースを計画的に提供し、他の仮想ワークロードや物理ワークロードに影響を与えないようにしなければならない。図2のように、先述のシナリオと同様のハードウェア仕様を持つセカンダリ物理ホストを追加して、物理リソース要素と仮想リソース要素のロードバランシングに着手することができる。
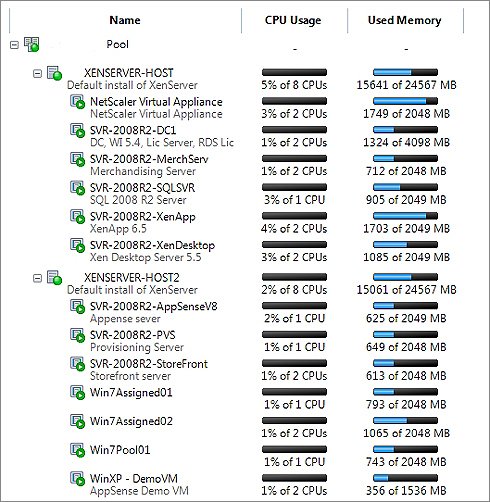 (図2)XenServer 6.0 Enterpriseでは、複数のXenServerホストで構成されるリソースプールを作成できる。このプールではリソースが共有される。実行中のVMを、SANバックボーンを介してホスト間で動的に移行できるからだ
この新しいシナリオでは、2台の物理ホストで構成されるリソースプールにおいて、VM間でリソースが共有されている。実運用される全ての環境は、どれ1つとして同じものがないため、物理リソースのロードバランシングプロセスは、ケースバイケースで個別に計画しなければならない。この例の2台の物理ホストは、既存のVMの要求に余裕を持って対応できる豊富なリソースを持っている。この環境では、VMのアジリティが保証されるようにCPUやRAM、ストレージについて高い要件が設定されている。
また、多くの環境では、高可用性(HA:High Availability)を実現するためにロードバランシングを行うことが求められる。XenServer 6.0を例に見ると、ビルトインツールがこのプロセスに役立つ。XenServerプール(XenServerで作成されたリソースプール)のHA機能を利用すれば、管理者は、あるホストから別のホストにどのVMを安全にフェイルオーバーできるかを把握できる。さらに、エンジニアは、その処理のために物理マシンごとにどれだけのリソースが必要かを判断できる。
ここで留意すべき最も重要なことは、これら2台のサーバ間でロードバランシングが行われ、VMの新規作成、フェイルオーバー、ワークフロー自動化のためにリソースが提供されることだ。HAに関しては、物理サーバの1台で障害が発生すると、もう1台がそのホストの重要なVMを引き継げる。
マシン間でリソースのロードバランシングが行われていると、VMを物理ホスト間で必要に応じて、現在のリソース状態に影響を与えずに移動できる。ディザスタリカバリ(DR)の例を考えてみよう。こうしたロードバランシングのシナリオでは、物理ホストで障害が発生した場合、VMは、リソースが見つかる別の使用可能なホストに移行される。マシンのいずれかが完全に使用されていると、DRやフェイルオーバーは不可能になる。そのサーバでは、移動してくるVMをサポートするのに使用可能なリソースがないからだ。
次回は、ワークフロー自動化やアラート監視などの管理機能を紹介しよう。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

新着ホワイトペーパー PR
-
製品資料
[ファインディ株式会社] AI利用率だけでは説明できない成果 開発組織の競争力を生む「開発資本」とは? -
製品資料
[ニュータニックス・ジャパン合同会社] AI活用を成功へ導く、シンプルで費用対効果に優れたクラウド基盤とは? -
製品資料
[ニュータニックス・ジャパン合同会社] マネージドKubernetesには限界も――メリットをフル活用する新たな選択肢とは? -
技術文書・技術解説
[ニュータニックス・ジャパン合同会社] 決断の日が迫る「vSphere 8」サポート終了問題 考慮すべきリスクと選択肢は? -
製品資料
[サイバーソリューションズ株式会社] メール誤送信対策のルールが肥大化 苦しむ情シスはどうすれば救われるのか?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
2
「アップグレードできないJava」をどう守る IBMとRed HatがAIで400件超修正
-
3
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
4
Copilot導入で陥る“目的化”の落とし穴 定着の鍵は「作り込まない」こと
-
5
パッチなしで「今すぐサーバを落とせ」 Kiteworks異例警告の波紋
-
6
kintoneで実践 製造業のための「見積もり管理」改善のヒント
-
7
「IoT通信環境の構築・運用」に関するアンケート
-
8
OpenAIやAnthropicでさえ制御不能 2026年夏「3大サイバー攻撃」の衝撃
-
9
祝10周年! 創業者も予想できなかったRaspberry Pi活用例
-
10
「サイバー犯罪株式会社」に潜入 現地調査で判明した“犯罪者求人”の実態
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
4
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
5
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
6
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
7
「IT史に名を残すシステム障害」8選
-
8
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
9
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
10
マンガで学ぶXDR/MDRのメリット、中小企業のセキュリティ強化になぜ有効か?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー