




















ビッグデータのためのDWH基盤【第3回】
列単位格納でビッグデータの高速処理を実現するカラム型データベース
ビッグデータの高速処理基盤として注目されているカラム型データベース。代表製品は近年大手ベンダーが買収した製品が目立つ。カラム型データベースの特徴と、どのような場合に利用が適しているかを解説する。
カラム型データベース登場の背景
一般的なリレーショナルデータベース管理システム(RDBMS)は、もともと業務系アプリケーションの構築を想定して機能を進化させてきたが、1990年ごろから情報系アプリケーション、すなわちデータウェアハウス(DWH)の構築にも利用されるようになる。それに伴い、DWH構築に必要な機能、つまり、スタースキーマで実装されたデータベースの検索性能を向上させる機能も積極的に強化されるようになった。
このようなDWH向けに実装された機能の代表的なものに、ファクトテーブルを分割してスキャンできるパーティション機能や、特定の列に沿って集約したテーブルを自動的にメンテナンスするサマリーテーブル機能などがある。しかし、DWHにおいて頻繁に発生する全件検索のような処理は大量のディスクI/O処理を必要とするため、RDBMSでDWHを構築する際の一番のボトルネックとなっていた。
このようなDWH特有の問題を解決するために登場したのが「カラム型データベース」である。一般的なRDBMSではディスクへのデータ格納が行単位で行われるのに対して、カラム型データベースでは列(カラム)単位で行われる。カラム型データベースは、カラム(列)指向データベース、カラムストア型データベース、カラムナデータベースなどと呼ばれることもある。
ビッグデータのためのDWH基盤連載インデックス
カラム型データベースの特徴
カラム型データベースは、列単位でディスクへのデータ格納が行われるため、全てのレコードの特定のカラムを読み出す場合、隣接したディスク領域にアクセスすることで高速処理を可能にしている。
また、カラム型データベースでは、1つの列に含まれるデータは連続した同一データの重複を排除した形で格納されている。例えば、1行目から50行目までが「A」、59行目から80行目までが「B」、81行目から100行目までが「C」というデータが存在する列を想定してみよう。標準的なデータベースでは100フィールド分(例えば100ワード)の領域が必要だが、カラム型データベースでは、「A」「50(回連続)」「B」「30(回連続)」「C」「20(回連続)」という形で格納されるので、必要な領域は6フィールド分(例えば6ワード)で済む。このため読み出しの際に必要なディスクI/Oが削減され、結果として処理が高速化される。
さらにデータ圧縮の観点でいえば、列単位で格納されたデータは、文字列なら文字列、整数なら整数といった具合に同一の属性を持つため、標準的な圧縮アルゴリズムを適用した場合の効果が大きくなる。
もちろん、カラム型データベースが一般的なRDBMSより全ての局面で有利というわけではない。一般の業務アプリケーションでは、行単位の書き込み、読み込みの方が頻繁に発生するため、カラム型データベースはこのようなアプリケーションでは不利となる。DWHにおいても、特定の行に対する訂正のような処理が頻繁に発生するような場合は、注意が必要となる。
カラム型データベースのスイートスポット
本連載の第1回「読めば分かる! ビッグデータのためのデータウェアハウス(DWH)とは?」で、DWHのデータ構造としてスタースキーマと大福帳スキーマについて説明した。カラム型データベースは、もともと列単位でのデータ格納と圧縮効率の良さを特徴とするため、必ずしもスタースキーマに見られる正規化、集約を必要としない。そういった意味で、カラム型データベースは大福帳スキーマに適しているといえる。さらに、同じ大福帳スキーマであっても、カラム型データベースがより有利となる局面が2つある。
1つ目は、データのカーディナリティが低い場合である。カーディナリティはもともと集合理論の用語で「濃度」とも呼ばれる。データベース分野では、特定のカラムに含まれるデータの種類、もしくはレコードの数に対するデータの種類の比率を表す。いずれの場合でも、データの種類が少ない(比率が低い)ことを「カーディナリティが低い」という。例えば、「性別」というカラムに含まれるデータの種類は、「男性」「女性」の2種類しかないため、カーディナリティの低いデータの代表例といえる。連続した同一データの重複を排除した形で格納するカラム型データベースにおいては、カーディナリティが低い方が、同じ値が連続して現れる可能性がより高くなり、有利といえる。
もう1つは、ファクトレスファクトテーブルとなる場合である。スタースキーマにおけるファクトテーブルが数値カラムを持たない場合、そのファクトテーブルをファクトレスファクトテーブルと呼ぶ。
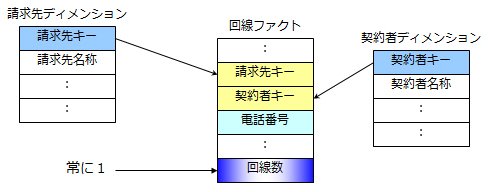 ファクトレスファクトテーブルの例
スタースキーマの場合、このような数値項目がないファクトテーブルには、疑似的な数値カラム(図では回線数)を作成し、値を常に1とする。
ファクトレスファクトテーブルは、スタースキーマにおける概念であるが、大福帳スキーマにおいても同様のケースは発生する。このような場合、データの集計処理とは数値カラムの値を足すのではなく、検索条件に合うデータ(レコード)の数をカウントする処理を意味する。当然、このような処理を行う場合、特定のカラムに対して全件(全レコード)の読み込みが頻繁に行われので、カラム型データベースが有利となる。
ビッグデータとカラム型データベース
カラム型データベースとして最初に登場したのはSybaseIQだと思われるが、その後、数々のカラム型データベースが登場し現在に至っている。特徴的なことは、2010年から2011年にかけて大手ベンダーに買収された製品が多いことである。
| 製品名 | ベンダー | 備考 |
|---|---|---|
| Aster Data | Teradata | 2011年にTeradataがAster Data Systemsを買収 |
| Greenplum | EMC | 2010年にEMCがGreenplumを買収 |
| InfiniDB | Calpont | OSSとしても入手可能 |
| Infobright | Infobright | OSSとしても入手可能 |
| SybaseIQ | SAP | 2010年にSAPがSybaseを買収 |
| VectorWise | Actian | 2011年にIngresから社名変更 |
| Vertica Analytics Platform | HP | 2011年にHPがVerticaを買収 |
また、ここにきて一般的なRDBMSにカラム型データベース的な機能を付加する動きも出始めている。「Oracle Exadata」のHybrid Columnar Compressionや「Microsoft SQL Server 2012」のカラムストアインデックスなどはその例といえる。このような傾向は、ビッグデータが注目されるようになったことと無関係ではなく、より大量のデータに対する分析アプリケーションのニーズが高まってきたことが背景にあると思われる。
ただし、NoSQLデータベースが短時間に大量に発生するデータの処理を並列処理によるスケールアウトで解決しようとしてきたのに対し、カラム型データベースはもともとDWHのボトルネックであるディスクI/Oを、列単位でのデータ格納と効率的なデータ圧縮で解決するという全く別のアプローチだといえる。
平井明夫
株式会社アイエイエフコンサルティング
マーケティング部 マーケティングディレクター
日本DEC(現日本ヒューレット・パッカード)、コグノス(現日本アイ・ビー・エム)、日本オラクルを経て、現在はアイエイエフコンサルティングに在籍。一貫してソフトウェア製品の開発、マーケティング、導入コンサルティングを歴任。特に、DWH、BIを得意分野とする。現在はBI技術の啓蒙のため、講演・執筆に積極的に取り組んでいる。
Copyright © ITmedia, Inc. All Rights Reserved.


ビッグデータのためのDWH基盤
この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社MatrixFlow] 「物流リソース最適化」ガイド:人員・配車・傭車を出庫依頼の確定前に決めきる -
製品資料
[株式会社キーエンス] なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは -
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
2
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
3
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
4
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
5
情シスの約8割が転職や退職を意識 調査で分かった“辞めたくなる最大の理由”
-
6
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
7
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
-
8
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
9
「結局使わなくなる」Microsoft 365 Copilotを半年で定着 キリンの3施策
-
10
「中堅・中小企業のネットワーク・セキュリティ運用実態」に関するアンケート
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
4
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
5
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
6
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
9
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー