




















物理コアの役割分担が決め手に
キャッシュメモリと物理コアの使い分けで「ムーアの法則」に挑戦するメインフレームプロセッサ
IBMはメインフレームプロセッサの処理能力を高める手法として、キャッシュメモリと物理コアコントロール技術に着目した。この技術が利用する「HiperDispatch」という機能とともに、その概要を説明しよう。
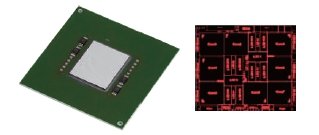
ムーアの法則がいずれ成立しなくなるのは不可避だが、IBMはこの状況に備えるべく、従来とは異なる方法でプロセッサの能力を高めようとしている。同社が利用するのは、命令パイプライン化、ハイパースレッディング、プロセッサキャッシュといった手法だ。
これらの手法は、システムの処理内容によっては、メインフレーム性能に変革をもたらすかもしれない。メインフレームの性能を最大限に発揮できる手法の1つが、プロセッサのキャッシュメモリと物理コア制御の最適化だ。
メインフレームプロセッサだから重視すべき機能とは
最近のメインフレームプロセッサは、命令パイプラインへのフィードでキャッシュメモリを積極的に利用する。IBMメインフレームの最新モデル「z13」が搭載するプロセッサは、扱う容量とセントラルプロセッサ(CP)からの距離が異なる4レベルのキャッシュメモリを備える。プロセッサの物理コアはそれぞれ1次(レベル1、L1)キャッシュメモリと2次(レベル2、L2)キャッシュメモリを搭載する。3次(レベル3、L3)キャッシュメモリはプロセッサに実装する全ての物理コアが共有し、4次(レベル4、L4)キャッシュメモリは同じドロワーに搭載した全てのプロセッサがアクセスできる。ただし、プロセッサが利用するデータはL1キャッシュメモリ内に存在しなければならない。
メインフレームは、異なるワークロードを高い効率で処理する必要がある。これは、オンライントランザクションと巨大ファイルを処理するバッチジョブなどで、ハードウェアレベルで頻繁なコンテキストスイッチを実施することを意味する。
業務部門と開発部門で共有するメインフレームを例に説明しよう。このメインフレームでは、業務用の論理区画(LPAR:Logical PARtitioning)を稼働するときに作業データのセットをキャッシュメモリに構築する。こうすることで、プロセッサがメモリあるいは下位キャッシュメモリからデータを読み出す時間が短縮するため、パフォーマンスが向上する。その後、ある時点で業務用LPARはCPの制御を開発部門のテストシステムに渡す。開発用LPARは同様に、必要なデータをキャッシュに収集するプロセスを実行して効率改善を達成したら、業務用システムに制御を戻す。最大負荷が掛かったプロセッサでは、この制御システムが切り替わるときに発生するスラッシング(物理メモリが不足してシステムの処理能力がデータの読み出しと書き込みで“手がいっぱい“になった状態)はパフォーマンスの低下とプロセッサ処理能力の浪費につながる。
メインフレームでは、この状況の改善にキャッシュメモリの多層制御とプロセッサの物理コアに対する動的割り当てを利用できる。この方法では各LPARを同じ物理コアに置くことにより、キャッシュデータの読み出しと消去にかかる時間を短縮するのが目的だ。IBMは、この制御を促進するために「HiperDispatch」機能と効果を計測するための2つの指標を提唱した。
HiperDispatchを有効にすると、OSディスパッチャーがメインフレームハイパーバイザー「Processor Resource/System Manager」(PR/SM)と連係する。両者は協調動作を通じて、全てのLPARに対して、同じ物理コアで整合性を維持することにより、キャッシュデータの内容を保持してキャッシュミスを減らし、処理効率を高める。
キャッシュメモリ利用効率を示す指標の1つがRNI(相対ネスト集中度)だ。IBMはさまざまなレベルのキャッシュとメモリからデータを読み出す時間に基づいて、各メインフレームプロセッサモデルによって異なる複雑なRNI計算式を用意している。低いRNIはキャッシュの利用が効率的であることを示す。これはプロセッサが命令とデータを待つ時間が短いことを意味する。
第2の指標がCPI(1命令当たりのクロック数)だ。これは、1つの命令を実行するのに必要なクロックサイクル数を示す。プロセッサからキャッシュメモリまたはシステムメモリへの距離が遠いほど、1つの命令を実行するのに必要なサイクル数が多くなる。CPI値は小さいほど処理速度が速いことになる。これは、同じプログラムの同じデータでも、キャッシュメモリの奪い合いによってCPUの消費量が異なることを示す分かりやすい“ものさし”としても使えるだろう。
物理コアにおける役割分担とは
物理コアの役割には次に示す3つのモードがある。
- バーティカル・ハイ(VH):実質的に1つのLPAR専用になる物理コア
- バーティカル・メディアム(VM):複数のLPARで共有できる物理コア
- バーティカル・ロー(VL):必要になるまで待機する物理コア
一般に、PR/SMはLPARウェイトと論理コアまたは物理コアの数に基づいて適切なモードを割り当てる。LPARウェイトは、区画の相対的重要性とビジー状態(負荷が掛かり過ぎて処理能力をフルで使っている状態)にあるコアの割り当て量を指定する。
HiperDispatchを有効にすると、個々のLPARウェイトを総LPARウェイトで割り、これに物理コアの数を掛けて、1つのLPARが使用できるCPの数を決定する。実際には、z/OS(IBMが開発したメインフレーム用OS)とPR/SMが連係している場合、各z/OSはできる限り1つのVHモード物理コアに処理を割り当てようとする。VHモードの物理コアが過度にビジーになると、MHモードの物理コアに処理を送る可能性がある。
PR/SMはプロセッサが実装するキャッシュ構造を認識しているので、CPを同じ物理コアまたは近くの物理コアにあるLPARへ割り当てることにより、データを読み出す時間を短縮する。PR/SMの意思決定は複雑で分かりにくいため、開発者はIBMの「LPAR Design Tool」をダウンロードして使うのがいいだろう。このツールは複雑な「Excel」ワークシートの形で提供されており、これを使ってLPARを構成するとハードウェアを最適化できる。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社MatrixFlow] 「物流リソース最適化」ガイド:人員・配車・傭車を出庫依頼の確定前に決めきる -
製品資料
[株式会社キーエンス] なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは -
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
2
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
3
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
4
「IBM iはDXのボトルネック」は誤解 意外と知らない今風モダナイズの効果
-
5
「朝8時にバッチが終わらない」データ爆発の危機をJPX総研はどう乗り越えたか
-
6
「中堅・中小企業のネットワーク・セキュリティ運用実態」に関するアンケート
-
7
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
8
AI導入後に発覚する「社内文書を読めない」問題 情シスは何を直せばいい?
-
9
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
-
10
情シスの約8割が転職や退職を意識 調査で分かった“辞めたくなる最大の理由”
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
4
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
5
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
6
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
9
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー