




















実験段階だが話題のSpark on Kubernetes
ビッグデータ活用で勢いを増すコンテナと「Kubernetes」導入
ビッグデータのベンダーやユーザーは、「Kubernetes」のコンテナ管理に目を向けている。コンテナによってシステムやアプリケーションの導入が高速になり、コンピューティングリソースの利用が柔軟になるためだ。
ビッグデータ導入プロセスをコンテナ化する試みは、まだ始まったばかりだ。とはいえ、ビッグデータのシステムとアプリケーションの導入を容易にするツールとして、コンテナと「Kubernetes」に注目するユーザーやベンダーが増えている。Kubernetesは、コンテナを編成/管理するテクノロジーだ。
この試みを早くから取り入れているベンダーやユーザーは、Kubernetesクラスタでビッグデータコンテナを実行して、システムのビルドとアプリケーションコードを再利用することで、開発や導入の作業速度を上げたいと考えている。このコンテナアプローチにより、システムやアプリケーションを新しいプラットフォームに簡単に移行できるようになる。また、コンピューティングリソースをワークロードの変更に合わせて再配置したり、企業内で利用可能なITインフラの使用を最適化したりすることも容易になる。
併せて読みたいお薦めの記事
サーバレス vs. コンテナ
Kubernetes活用ノウハウ
ビッグデータテクノロジーのベンダーが自社の製品にコンテナとKubernetesのサポートを追加するペースは勢いを増している。例えば2018年3月、米国で開催された「Strata Data Conference」では、MapR Technologiesが、Kubernetesボリュームドライバーを同社のビッグデータプラットフォームに統合したことを発表した。同社はこの統合により、このオーケストレーションテクノロジーに結び付けられているコンテナ化アプリケーション向けに永続データストレージを提供するという。
MapRでは以前、同社の「MapR Converged Data Platform」への組み込み接続を備え、特殊化した「Docker」コンテナの使用をサポートしていた。だがKubernetes拡張機能の方が「環境に対してはるかに透明性がありネイティブだ」と話すのは、MapRでデータおよびアプリケーション部門のシニアバイスプレジデントを務めるジャック・ノリス氏だ。また、この永続ストレージ機能により、ステートフルなアプリケーションでコンテナを使えるようになると同氏は補足する。このことは「Hadoop」や関連テクノロジーを使用した一般的なビッグデータ導入の要件になっている。
さらに、2018年2月後半にリリースされたオープンソースの「Apache Spark」処理エンジンのバージョン2.3アップデートには、ネイティブKubernetesスケジューラーが含まれている。Bloomberg、Google、Intelなど複数の企業が開発に参加しているこの「Spark on Kubernetes」は、実際にはまだ実験段階だという。とはいえ、これによりSpark 2.3ワークロードをKubernetesクラスタで実行できるようになる。
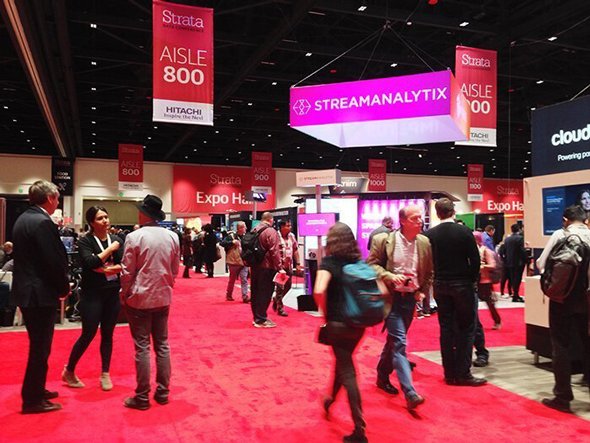 米国で開催された2018年の「Strata Data Conference」で話題になったビッグデータシステムとアプリケーションのコンテナ化
負けじとばかりに、間もなくバージョン1.5がリリースされる「Apache Flink」では、Kubernetesのライバル「Apache Mesos」とのつながりも強めようとしていると話すのは、「Apache Flink」のベンダーでData Artisansの共同創設者兼ソフトウェアエンジニアを務めるファビアン・ヒュースキ氏だ。FlinkはSparkのライバルとなるストリーム処理プラットフォームだ。ユーザーは、Data Artisansが提供する最新のFlinkディストリビューションをKubernetes上で実行できる。「ただし、今すぐに行うのは必ずしも簡単ではない。新しいリリースの方がはるかに容易になる」というのが「Strata Data Conference」でのヒュースキ氏の発言だ。
軌道に乗るビッグデータコンテナ
中国のオンライン小売業者JD.comは、Spark on Kubernetesを早くから導入している。同社は、「TensorFlow」や「Caffe」といった機械学習フレームワークや深層学習フレームワークも単一のKubernetesベースアーキテクチャでコンテナ化している。同社はこのアーキテクチャを「Moonshot」と呼ぶ。
コンテナの使用は、この新しいアーキテクチャで実行される機械学習やその他のAI分析アプリケーションをサポートする中で、ビッグデータの導入作業の効率を上げ、簡略化することを意図している。JD.comでソフトウェア開発エンジニアを務めるジェン・ファン氏はカンファレンスのセッション内でそう説明し、次のように述べた。「1つのクラスタで全てのAIワークロードをサポートすれば、リソースの使用率を最大限に高めることができるのではないかというのが主な検討事項だった」
一方で、コンテナを使用すると企業のWebサーバに分析システムを素早く導入することも可能になると同氏は補足する。コンテナを利用すれば、処理が行われていない夜間を活用できる。
「eコマースでは、Webサーバの稼働率が真夜中になるまでは非常に高い。だが深夜12時から午前6時までならば、一部のオフラインジョブの実行に使用できる」(ファン氏)
JD.comは2017年半ばにこのAIアーキテクチャの取り組みに着手した。ファン氏によると、現状同社には、コンテナで運用ジョブを実行しているノードが300あるという。また、近い将来ノード数を1000に増やす予定だ。Spark on Kubernetesテクノロジーは2017年の第3四半期に導入した。当初はSparkのストリーム処理モジュールを使用して実行されるアプリケーションのサポートが目的だった。
だが、そうした目的での導入は、運用環境でSpark on Kubernetesを利用する準備が整っているかどうかをテストするための概念実証プロジェクトにとどまっている。Intelで上級ソフトウェアエンジニアを務めるウェイ・ティン・チェン氏はそう説明する。IntelはJD.comを支援してアーキテクチャを構築している。チェン氏は、SparkにはKubernetesにまだ結び付けられていない要素が幾つかあると指摘する。また評価すべき問題についても言及した。
同氏によると、JD.comとIntelはKubernetesを使用することで、例えば大量のコンテナを起動したときにパフォーマンスのボトルネックが発生するかどうかを確認しているという。もう1つの懸念は信頼性だ。ますます多くの処理ワークロードがSpark on Kubernetes経由で実行されるため、信頼性が重要になるとチェン氏はいう。
最先端でのKubernetes利用
Spark on Kubernetesは、現時点では「技術力」が十分ある企業がビッグデータを導入する場合に最適かつ最先端のテクノロジーになる。Pepperdataで製品管理部門のディレクターを務めるビノッド・ナイル氏はそう主張する。同社は、ビッグデータシステム用のパフォーマンス管理ツールのベンダーであり、Spark on Kubernetesの開発作業に携わっている。
ナイル氏によると、このKubernetesスケジューラーはSpark 2.3のプレビュー機能であり、今後6~12カ月は一般公開の準備が整いそうにないという。「これは非常に大規模な取り組みだ。そのため、運用環境で公開するまでにある程度の時間がかかると見込んでいる。現時点ではαテストの段階だ」
PepperdataではSparkと「Hadoop Distributed File System」(HDFS)に対応するKubernetesベースのコンテナを同社の一部の製品でサポートすることを予定している。Pepperdataは、手始めとして、ビッグデータアプリケーション開発者向けのパフォーマンス管理ポータル「Application Spotlight」を2018年3月に発表した。最近リリースされた「Hadoop 3.0」では、Hadoopに組み込まれたYARNリソースマネジャーでもDockerコンテナを制御できる。だが「Kubernetesにはそれ自体が実行しようとしていることに対し、もっと大きな野望があるような印象を受ける」とナイル氏は感じている。
全ての企業がKubernetesに夢中になっているわけではない。BlueData Softwareはカスタムオーケストレーターを使用して、同社のBigData as a Serviceの中核を成すDockerコンテナを管理している。BlueData Softwareの共同創立者でありチーフアーキテクトを務めるトム・フェラン氏は、特にステートフルなアプリケーションについては自社製のツールの方がKubernetesよりも技術的に優位だと考えている。ただし同社では、今後導入する可能性を念頭に置いてラボ環境でKubernetesを扱っているという。
Pinterestも同じことを行っている。同社はDockerコンテナを使用して、さまざまな機械学習アプリケーションの開発と導入を高速化しようと取り組んでいる。こうしたアプリケーションを社内で使用することにより、同社が提供する画像ブックマークやソーシャルネットワークサイトを推し進めることができる。そう説明するのは、Pinterestで上級ソフトウェアエンジニアを務めるキナリー・ジャングラ氏だ。
ジャングラ氏は、機械学習モデルをデバッグするためのコンテナベースの構成をテストケースとして構築した。「Strata Data Conference」での同氏のプレゼンテーションによると、PinterestではKubernetesクラスタもテストしているという。「運用環境への移行時にこれが役に立つかどうかを確認しようとしている。だが、まだその段階まで達していない」とジャングラ氏は話す。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社MatrixFlow] 「物流リソース最適化」ガイド:人員・配車・傭車を出庫依頼の確定前に決めきる -
製品資料
[株式会社キーエンス] なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは -
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
2
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
3
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
4
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
5
肥大化した「SFA」の沼 4カ月でBigQuery×AppSheetの新システムを構築した方法
-
6
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
7
次世代RPA「ハイパーオートメーション」が急成長か Gartnerが予測
-
8
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
9
昭和大学病院がeICUを導入、ICUの患者情報を遠隔地で一括管理
-
10
「何から始めればいい?」 情報漏えい対策で悲鳴を上げる中小企業のリアル
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
プログラミング不要で誰でも実現できる、ネットワーク運用管理の自動化とは
-
4
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
5
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
6
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
-
9
“あのファイル転送”で暗躍するノーウェアランサム
-
10
「オンプレミス回帰」せざるを得ない“合理的な理由”
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー