




















AI-readyなデータ基盤の現実解
生データをAIに渡すな デジタル庁が明かすMCP×意味定義の実践知
AIに生データを渡すだけでは誤集計は防げない。デジタル庁が約7.5万件のデータで検証した、MCPと意味定義層でLLMの誤読を抑え込む「AI-ready」な設計思想と実装手法を解剖する。
社内データを生成AIに渡して分析させようとしたものの、計算ミスや項目の取り違えが多発し、結局人間がExcelで検算し直す羽目になった経験はないだろうか。デジタル庁は2026年8月13日、国の行政手続などについての調査データ約7万5000件を対象に、対話形式の自然言語で分析できる検証用実装をGitHubで公開した。
AIに生データを直接渡さず、LLMには検索条件の指定のみを担わせて計算を外部サーバ側で処理する構成を採った。以下では、データの誤読や不適切な集計を抑え込むための意味定義層と品質管理の仕組みを解剖する。
生データを渡さずサーバ側で集計を実行
今回の検証で対象としたのは、デジタル庁が公表する国の法令などに基づく行政手続などのオンライン化状況などをまとめた調査データ(38列、約7万5000件)だ。事業者が直面する手続の電子化状況や、引越し・結婚・法人設立といったライフイベント横断の手続件数を自然言語で検索・集計できる。
最大の特徴は、生データをLLMに直接読み込ませるのではなく、外部連携の標準規格である「MCP(Model Context Protocol)」を採用した点にある。LLMの役割を検索や集計の条件指定にとどめ、算術処理はMCPサーバ側で完結させるアーキテクチャを採用した。これにより、LLM特有の計算ミスやコード値の誤用を防いでいる。
データの格納形式にはCSVではなく列指向の圧縮バイナリ形式である「Apache Parquet」を採用。約7万5000行、39列の調査データが約3MBに圧縮される。Parquetファイルの末尾に含まれるメタデータのみをサーバ起動時に読み込み、実データはクエリ実行時に初めてメモリへロードする遅延ロードによって省メモリ化を図っている。
国際標準SDMXを参考にした意味定義と品質把握
生データをMCP経由でAIに提供するだけでは、欠損値の扱いや指標の解釈ミスを防ぎきれない。そこで同実装では、統計データの国際標準規格「SDMX」のデータ構造定義(DSD)の考え方を参考に、独自形式の設定ファイル「dataset.yaml」を用意した。
この設定ファイルでは、分析の軸となる分類項目(dim)、数値項目(measure)、サーバ側で算出する指標(computed_measures)を定義している。例えば「オンライン手続件数」の欠損値(null)は「0件」ではなく「件数不明」を意味するといった解釈上の注意(notes)を付与し、AIが誤った推測で数値を引用しないよう制御している。
データの探索から分析までは、役割を分けた4つのMCPツールで実行する。データセットの存在を確認する「list_datasets」と構造を把握する「inspect_dataset」の探索層ツールを経て、実データの取得を行う「query_records」および「summarize_records」を呼び出す。inspect_datasetは設定ファイルの定義に加え、実データから充填率や数値統計を動的に算出してAIに返す仕様とした。
ユーザーインタフェースには、チャットUI内にグラフや表を直接表示できる拡張仕様「MCP Apps」を試作した。集計軸の数に応じて、円グラフ、棒グラフ、ヒートマップ、ツリーマップなどを自動で切り替えて描画できる。
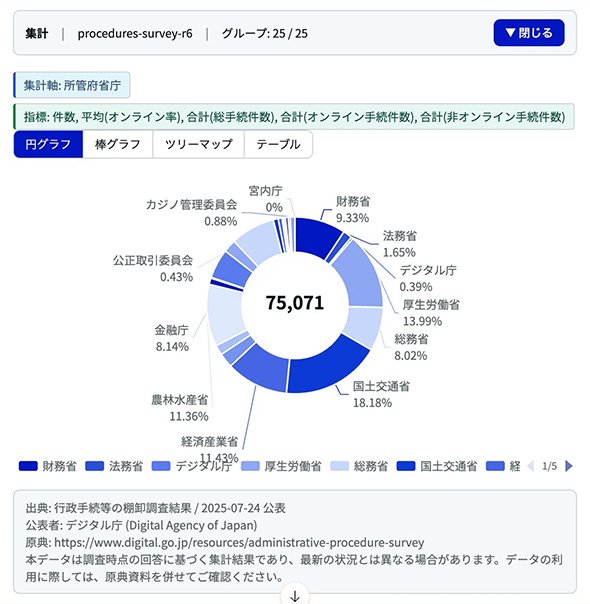 所管府省庁別の手続件数を円グラフで表示(画像出典:デジタル庁)
型揺れや漢字の誤読を吸収する対話向け設計
LLMがツールを呼び出す際に発生する入力の揺れでも、サーバ側で多層的な保護策を講じた。
LLMがツール引数を辞書形式で送るかJSON文字列で送るかが一定しない問題では、複数の入力形式を正規化して受け入れる処理を実装した。また、LLMが似た漢字を混同して出力する現象では、完全一致、Unicode NFKC正規化、ライブラリによる近似一致の3段階で項目名を照合する。近似一致はフィールド名という閉じた語彙(ごい)に限定し、誤補正を防ぐガードを設けた。
さらに、ツール応答を辞書の配列形式から列指向形式へ変換することで、キー名の繰り返しを排除し、消費トークン数の削減も図っている。
同実装はGitHubのリポジトリ「administrative-procedures-mcp」で公開されており、Python 3.10以上の環境で検証できる。また、ブラウザの内蔵AIを利用し、APIキーなしでローカル環境のみで動作を確認できるプレビュー機能も備えている。
Copyright © ITmedia, Inc. All Rights Reserved.


TechTarget ニュースプラス
国内のIT業界ニュースを迅速に報道します。企業動向から導入事例、市場トレンドまで幅広く取り上げ、実務に直結する情報をタイムリーに提供する連載です。
関連記事
新着ホワイトペーパー PR
-
製品資料
[ファインディ株式会社] AI利用率だけでは説明できない成果 開発組織の競争力を生む「開発資本」とは? -
製品資料
[ニュータニックス・ジャパン合同会社] AI活用を成功へ導く、シンプルで費用対効果に優れたクラウド基盤とは? -
製品資料
[ニュータニックス・ジャパン合同会社] マネージドKubernetesには限界も――メリットをフル活用する新たな選択肢とは? -
技術文書・技術解説
[ニュータニックス・ジャパン合同会社] 決断の日が迫る「vSphere 8」サポート終了問題 考慮すべきリスクと選択肢は? -
製品資料
[サイバーソリューションズ株式会社] メール誤送信対策のルールが肥大化 苦しむ情シスはどうすれば救われるのか?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「アップグレードできないJava」をどう守る IBMとRed HatがAIで400件超修正
-
2
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
3
「恥を知るべきだ」 AIデータセンター反対運動を招いた事業者の秘密主義
-
4
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
5
私も“AIエージェント開発者”に? 裾野を広げる「Agent Bricks」とは
-
6
パスワードはなぜ死んだか 情シスが今すぐ始めるパスキー移行の現実解
-
7
Copilot導入で陥る“目的化”の落とし穴 定着の鍵は「作り込まない」こと
-
8
パッチなしで「今すぐサーバを落とせ」 Kiteworks異例警告の波紋
-
9
「Windows」の不要なファイルを安全に消して容量を空ける方法
-
10
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
4
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
5
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
6
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
7
「IT史に名を残すシステム障害」8選
-
8
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
9
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
10
マンガで学ぶXDR/MDRのメリット、中小企業のセキュリティ強化になぜ有効か?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー