




















仮想環境のHAクラスタ製品 選定ポイント【第2回】
VMware環境のHAクラスタ製品の選び方 ~仮想マシン間HAクラスタ編
VMware環境のHAクラスタ方式の1つである「仮想マシン間HAクラスタ」に着目し、製品選定を行うために必要な知識(動作、メリット/デメリット、製品選定ポイント、推奨する設計・運用)を紹介する。
第1回「仮想化特有の課題がある、VMware環境の“従来型”HAクラスタ」では、VMware環境に物理環境と同様のHAクラスタ製品を用いることで生じる課題について紹介した。第2回、第3回では、それらの課題に対処し解決するための、HAクラスタ製品の選定ポイントを紹介する。
製品を選ぶ際は、いきなり製品比較を始めるのではなく、要件の整理と確認から始まり、方式選定、製品比較、製品選定の順で進めるべきである。
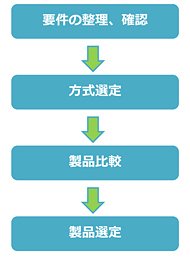 図1 製品選定の流れ
これはHAクラスタ製品に限ったことではなく、どんな製品を選定する場合も同じことがいえる。幾つかのメーカーの製品説明を聞いただけで製品比較を始めてしまうと、方式の異なる製品を比較してしまうことが多い。焦点が曖昧なので、その結果、労力をかけた割には内容の薄い比較となってしまう。まずは要件を整理した上で方式を選定する。そして、その方式を実現する製品について機能比較を行うのが正しいやり方だ。その後、製品ごとの機能やコストを比較し、想定内の予算に収まる製品を選定するという流れである。
VMware環境のHAクラスタは「仮想マシン間HAクラスタ」だけではない。大きく分けて3つの方式がある。
(1)仮想マシン間HAクラスタ
(2)vSphere HA
(3)vSphere HA+アプリ監視
第1回で説明した(1)仮想マシン間HAクラスタと、VMwareのHAクラスタ機能である(2)vSphere HA、それにアプリケーション監視を加えた(3)vSphere HA+アプリ監視の計3つの方式である。
今回は、(1)仮想マシン間HAクラスタの製品選定を行うために必要な知識として、「動作」「メリット/デメリット」「製品選定ポイント」「推奨する設計・運用」について紹介していく。
(2)vSphere HA、(3)vSphere HA+アプリ監視については、次回の第3回で説明する。
(1)仮想マシン間HAクラスタ
動作
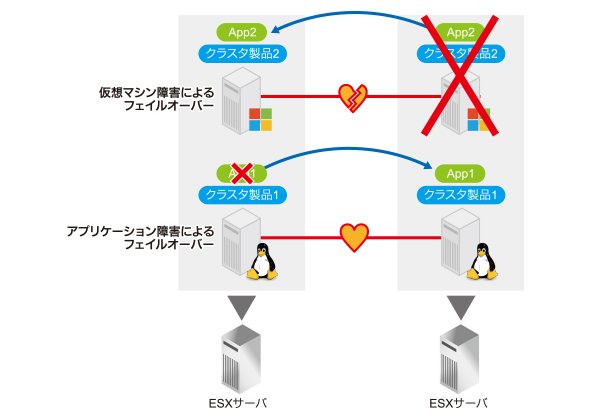 図2 仮想マシン間HAクラスタの動作
仮想マシン間HAクラスタでも物理環境のHAクラスタと同様に、稼働系と待機系の仮想マシンがそれぞれ起動し、仮想マシン上のクラスタ製品がハートビートでお互いのゲストOSの稼働状態を監視している。アプリケーションの他、仮想マシン上から見たNICや共有データ領域も監視している。
稼働系の仮想マシンが障害で停止すると、待機系の仮想マシンがハートビートでそれを検知し、待機系にサービス用IPの付与、共有データ領域のマウント、アプリケーションの起動を行い、フェイルオーバーが完了する。
稼働系のアプリケーションに障害が発生した場合は、稼働系でアプリケーションの停止、共有データ領域のアンマウント、サービス用IPの停止をした後、待機系でそれらを起動し、フェイルオーバーが完了となる。
メリット
- 物理環境からの移行が容易
物理環境で使用していたHAクラスタ製品とその設定、アプリケーション監視のためのスクリプトなどをほぼ変更せずにそのまま使用可能である。
- 物理サーバと仮想マシンでのHAクラスタ構成が可能
2台構成(1対1構成)のクラスタを複数セット構築すると、アプリケーションが稼働していない待機系が複数台存在することになり、システムリソースが無駄になる。物理環境では、物理サーバの台数を削減するために、複数台の稼働系に対応する待機系を1台に兼任させた構成(N対1構成)を組む必要があった。その場合、多ノード構成が可能なHAクラスタ製品を使用する必要があり、ハートビートやクラスタ設定が複雑になりがちだった。
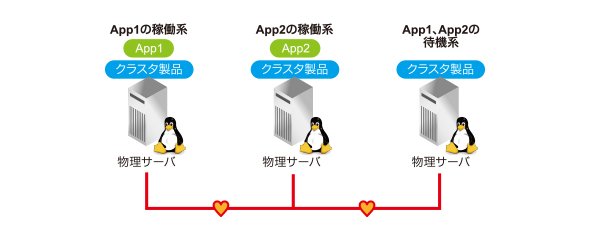 図3 物理環境のN対1 HAクラスタ構成
待機系の仮想マシンをESXサーバ上に複数構築することで、それぞれのクラスタは1対1となり、構成がシンプルになる。ただし、仮想マシンと物理サーバの共有データ領域はRDM(Raw Device Mapping)で構成する必要がある。
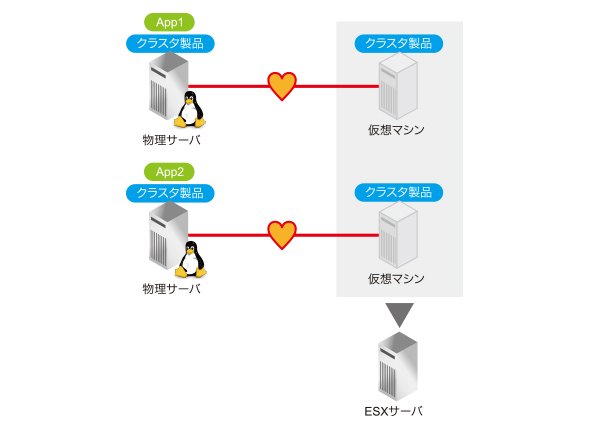 図4 物理サーバと仮想マシン間でのクラスタ構成
- 仮想マシンの電源停止を検知可能
稼働系/待機系の仮想マシンがハートビートでお互いのOSの稼働状態を監視しているため、OSのハングアップ(※1)、リブートに加え、仮想マシンの電源が停止した場合も検知することができる(※2)。これにより、仮想マシン電源停止時もアプリケーションをフェイルオーバーすることができる。
※1 ここでいうハングアップは、単なる高負荷状態ではなく、「仮想マシンの電源は入っているが、ネットワークとディスクへ読み書きが行われていない状態」を指す。
※2 vSphere HAは仮想マシン電源停止を障害とは認識しない。
デメリット
仮想マシン間HAクラスタのデメリットについてまとめると下記のようになる。第1回も併せて参照していただきたい。
- vSphere HAと比較して、構成が複雑になる(複数の仮想マシン、共有データ領域、ハートビート専用ネットワーク)
- vSphere HAと比較して、仮想マシンのスナップショットや「vSphere vMotion」「vSphere DRS」などのVMware環境の運用を効率化する機能と併用できない
- 物理環境のようにNIC、HBAのハードウェア障害を検知できない、もしくは検知してもフェイルオーバーできない可能性がある
製品選定ポイント
- Windows、Linuxの両方に対応しているか
Windows、Linuxの両方に対応し、それらを一元管理できるGUIが容易されているか。さらにUNIXにも対応している場合は、適応できる仮想/物理環境が増え、全体をより一層一元管理することができる。
- 複数のクラスタ間でのアプリケーションの起動/停止の順序が設定できるか
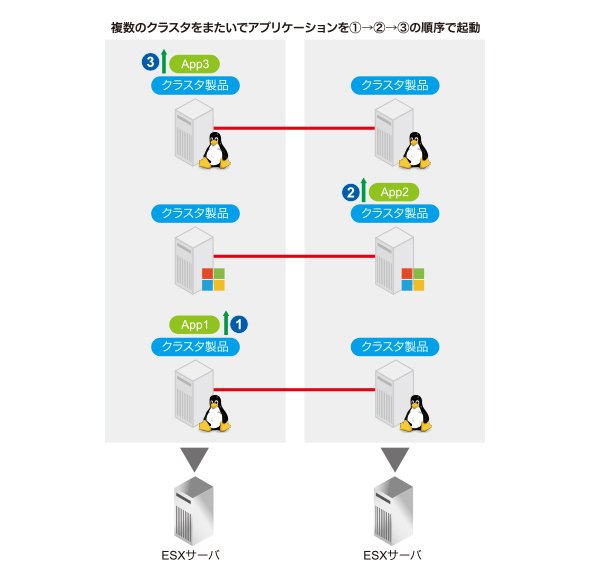 図5 クラスタ間でのアプリケーション起動/停止の順序設定
一般的なHAクラスタ製品は、1つのクラスタ内でのみアプリケーションの起動/停止順序を定義することができる。製品によっては、複数のクラスタ上のアプリケーション間で起動/停止の順序を設定できる。例えば、データベース(DB)サーバ、アプリケーションサーバ、Webサーバの順でそれができると、自律的な仮想基盤となり、手動作業が減り、運用の簡素化、人為的なミスやダウンタイムの削減につながる。なお、VMwareの機能では仮想マシンの起動順序は制御できるが、アプリケーションの起動順序までは制御できない。
- アプリケーション監視のエージェントが多く用意されているか、アプリケーション監視のスクリプトを作成する場合、作成しやすいシンプルなアーキテクチャか
仮想化基盤にクラスタを移行する際に、対応エージェントが多いことも重要だが、エージェントが用意されていないアプリケーションを監視する必要が多くなると思われる。その際、アプリケーションの起動/停止、監視を行うスクリプトを作成する必要が出てくるが、それらの仕様、仕組みがシンプルである方がよい。
起動/停止、監視処理のタイムアウト、リトライなどについて、個々のスクリプト内に繰り返し処理などを直接記述するのではなく、スクリプトにはメインの1回分のみを記述し、タイムアウト/リトライなどをクラスタのパラメータとして設定できるHAクラスタ製品の方がスクリプト作成は用意になる。
また、起動/停止スクリプトの中で正常に実施できたかを判断するロジックを記述するのではなく、起動/停止スクリプトは起動/停止処理のみを記述し、その後の監視処理で、処理の成功/失敗を判断するような仕組みの方がスクリプトの作成がシンプルになる。
- NICの監視方法が柔軟に選択できるか
NIC監視に、リンクアップ監視、特定IPまたはデフォルトゲートウェイへのping監視などから選択できるか。リンクアップ監視以外の監視を選択できると、物理NIC障害時に、仮想マシン上からそれを検知できる可能性が高まる。
ESXサーバのNICに障害が発生した際に、その仮想スイッチにひも付いている仮想マシンの仮想NICのリンクをダウンさせるような設定がVMware側で選べるようになれば、仮想マシン上で動作するクラスタ製品によって物理NIC障害を検知させることができるが、現在はそのような機能はない。今後、VMware側の機能追加を期待したい。
- 障害検知時に、仮想マシンを確実に停止できる手段を持っているか
ESXサーバとデータストア間の経路に障害が発生した際に、稼働系の仮想マシンのサービスを完全に停止できず、フェイルオーバーに失敗する場合がある。フェイルオーバーのためには、障害検知後のサービス停止の失敗は許されない。
そのためには、クラスタ製品は仮想マシンを確実に停止できる方法を持つべきである。OSの停止コマンドを常にメモリ上に保持できる製品や、VMwareと連携して仮想マシンを停止できるなどである。
- SCSIバス共有を設定しなくても、VMDK、RDMの共有データ領域を持ったクラスタを構成できるか
SCSIバス共有を設定すると、仮想マシンのスナップショットおよびvMotionができなくなる。これはバックアップやメンテナンスの運用上かなりのデメリットである。SCSIバス共有を設定する際は、スナップショットが存在する場合は削除し、その上、仮想マシンを停止しなくてはならない。このSCSIバス共有を仮想マシンに設定しなくても、HAクラスタ製品とVMwareが連携することで共有データ領域を持ったクラスタを構成できるクラスタ製品は、それができない製品と比較して運用上メリットがあるといえる。
仮想マシンからiSCSI、CIFS、NFSによって共有データ領域へ接続する場合、もしくはHAクラスタ製品のオプション機能によって仮想マシン間でデータ領域をミラーリングする構成の場合は、SCSIバス共有の設定は不要になる。
- vMotion連携が可能か
NIC障害など一部のハードウェアコンポーネントの障害の際は、アプリケーションを稼働系の仮想マシンから待機系の仮想マシンへ切り替えなくても、稼働系の仮想マシン自体をvMotionで他のESXサーバに切り替えることで復旧できる。「障害検知→vMotion開始→vMotion完了」の間、サービスのダウンタイムとなるが、アプリケーションの起動/停止が伴わないため、アプリケーションへのインパクトは少ない。2重化されている物理NICやHBAの片方に障害が発生した場合に、それを検知してvMotionが行える製品であれば、サービスダウンのリスクを軽減することができる。
推奨する設計・運用
HAクラスタを構成している仮想マシンは、複数台のESXサーバに分散して固定で配置し、vSphere HA、DRSの管理下から外すことを推奨する。vMotionで切り替わる際に、クラスタのハートビートの断線を検知してしまう可能性があるからだ。また、クラスタの稼働系と待機系の仮想マシンが同一のESXサーバ上に稼働してしまうと、それが単一障害点(SPOF:Single Point Of Failure)になる。
また、NIC、HBAについては、ESXサーバ内で2重化し、CIMやサーバベンダーが提供する監視の仕組み、vCenter Serverの通知機能を利用し、障害を検知した際は速やかに交換し、2重障害にならないことを前提とする運用を推奨する。
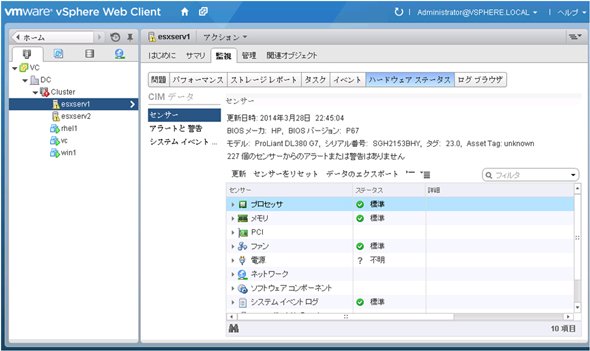 図6 ハードウェアステータスの確認《クリックで拡大》
今回は、仮想環境のHAクラスタの課題を解決するための、(1)仮想マシン間HAクラスタの製品選定ポイントについて解説した。運用で回避しないといけない点も正直多々あるが、仮想環境に適したクラスタ製品についてご理解いただけたと思う。次回は、(2)vSphere HAについても同様に紹介する予定である。
Copyright © ITmedia, Inc. All Rights Reserved.


仮想環境のHAクラスタ製品 選定ポイント
この記事の著者
関連記事
新着ホワイトペーパー PR
-
製品資料
[ファインディ株式会社] AI利用率だけでは説明できない成果 開発組織の競争力を生む「開発資本」とは? -
製品資料
[ニュータニックス・ジャパン合同会社] AI活用を成功へ導く、シンプルで費用対効果に優れたクラウド基盤とは? -
製品資料
[ニュータニックス・ジャパン合同会社] マネージドKubernetesには限界も――メリットをフル活用する新たな選択肢とは? -
技術文書・技術解説
[ニュータニックス・ジャパン合同会社] 決断の日が迫る「vSphere 8」サポート終了問題 考慮すべきリスクと選択肢は? -
製品資料
[サイバーソリューションズ株式会社] メール誤送信対策のルールが肥大化 苦しむ情シスはどうすれば救われるのか?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
2
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
3
Copilot導入で陥る“目的化”の落とし穴 定着の鍵は「作り込まない」こと
-
4
「アップグレードできないJava」をどう守る IBMとRed HatがAIで400件超修正
-
5
パッチなしで「今すぐサーバを落とせ」 Kiteworks異例警告の波紋
-
6
IT製品の導入に関するアンケート「セキュリティ」編
-
7
OpenAIやAnthropicでさえ制御不能 2026年夏「3大サイバー攻撃」の衝撃
-
8
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
-
9
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
10
LINEヤフーはなぜ「社内の管理者」すら信用しないインフラを作ったのか
ホワイトペーパーランキング PR
-
1
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
2
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
3
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
4
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
5
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
6
プログラミング不要で誰でも実現できる、ネットワーク運用管理の自動化とは
-
7
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
8
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
9
「IT史に名を残すシステム障害」8選
-
10
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー