




















有識者に聞く医療ビッグデータの現在と未来(1)
医療ビッグデータの意義が分かる5つの「V」
さまざまな定義が存在するビッグデータ。医療・ライフサイエンスのエキスパートは、医療ビッグデータでは5つの「V」が重要になると語る。医療ビッグデータを支えるインフラ基盤を探る。
医療ビッグデータのメリットと課題とは?
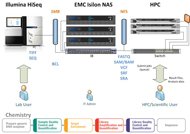 医療ビッグデータを支えるインフラ基盤の例(ジョシ氏提供資料より)《クリックで拡大》
IT技術が医療やライフサイエンス分野にもたらした恩恵は、大きく2つ挙げられる。1つは「膨大な情報処理が可能になり、より詳細かつ精度の高い研究ができるようになった」こと。もう1つは「X線装置やフローサイトメーター(注)などのライフサイエンス機器のデータを集約し、多角的な研究が可能になった」ことだ。
※注:フローサイトメトリー(細胞分析手法)に用いる測定装置。細胞の浮遊液や懸濁液を細管に通して、細胞数の計測や蛍光、散乱光の測定などを短時間で多量に行う。
その一方で、データ量も増えてビッグデータ化した結果、新たな課題が生まれている。米EMCのIsilonストレージ部門 ライフサイエンス CTO(最高技術責任者)であるサンジェイ・ジョシ氏は、医療ビッグデータの現状や課題を5つのキーワードで説明する。同氏は、ライフサイエンス機器の開発や、ゲノミクスやプロテオミクスの研究などライフサイエンス分野に25年以上従事してきたエキスパートだ。
医療ビッグデータで重要な5つの「V」とは?
さまざまなビッグデータの定義が存在するが、一般に「Volume」(量)、「Velocity」(速度)、「Variability」(可変性)の「3つのV」が、その特性として重要であるといわれている。ジョシ氏はそれらに加え、「Visualization」(可視化)と「Viscosity」(粘着性)の「5つのV」が医療ビッグデータでは重要になると語る。
Volume:人類誕生時からゼタバイト級のビッグデータ解析は始まっている
 米EMCのサンジェイ・ジョシ氏
人類が誕生した4~5万年前から1985年まで、言葉や絵画などで表現された情報は合計で約5Eバイト(エクサバイト)といわれている。だが、1985年から2000年にかけて生成されたデータ量も、約5Eバイト。そして現在、米Googleは2日ごとに5Eバイト以上のデータを生成している。米IDCの調査では、2020年には44Zバイト(ゼタバイト)に達すると予測されている。
だが、ライフサイエンスのデータはそれをはるかに上回る。ジョシ氏は「人間1人が保有するデータ量をバイト換算すると50Zバイト以上になる。つまり、人間は人類誕生時からゼタバイト級のビッグデータ解析を行っている」と語る。医療・ライフサイエンス分野のビッグデータのうち約80%は非構造化データであり、研究期間が長期にわたり保存義務もあるなどの理由からその大半が削除できない。「いずれは大規模なHPC(ハイパフォーマンスコンピューティング)に頼らざるを得なくなるだろう」との見解を示す。
Velocity:解析データをより迅速に提供してもらうことを求める
これまでの全ゲノム解析では、6カ月ほどの時間を要した。しかし、研究機器や化学的プロセスの改良が進んだ現在、医師は4~8時間以内に解析データがもらえることを期待するようになった。高速処理は必須要件だといえる。
Variety:多様な性質を持つ200万単位の膨大なデータ
ライフサイエンス分野ではさまざまなデータの種類が存在する。「いつ来院可能か」「診察日時はいつか」「退院時に受け取る書類は何か」といった患者に提供する情報から、電子健康記録(EHR)の「Meaningful Use Criteria(意義ある利用)」に該当する持参薬の確認やヘルスケアの高品質な情報、臨床の判断支援に関する情報まで、種類は多様だ。
加えて、その変数も膨大である。臨床システムで扱われる変数は200個程度だが、遺伝子学では約2万個、プロテオミクスに至っては200万個単位だ。しかも、人間のタンパク質は活発な細胞で、細胞内の1立方マイクロン(100万分の1メートル)中に200万種あるタンパク質のうち半分は、生存期間が5分以下だ。「5分ごとに利用価値のあるデータが生成・消滅を繰り返す。多様な性質を持つ膨大な数のデータにいかに対応できるかがポイントだ」とジョシ氏は説明する。
Visualization:患者に分かりやすく伝える仕組みが必要
ジョシ氏は生命情報学(バイオインフォマティクス)の研究者であるマーティン・クルジウィンスキ氏のWebサイト(mkweb.bcgsc.ca)を紹介し、「10の20乗の世界を分かりやすく見せることは非常に重要だ」と述べる。「これら変数がどのような意味を持つのか、医師が理解しやすいよう可視化し、医師はそれを患者に分かりやすく伝えられる仕組みも、併せて考えなければならない」(同氏)
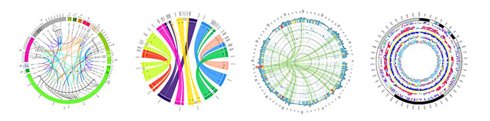 ゲノムデータとその注釈を円柱表示して可視化する「Circos」の表示例(出典:Genome Sciences Center)《クリックで拡大》
Viscosity:データの関連性を考慮すべき
データは元来、他の属性のデータと何らかの接点、つまり粘着性を持っている。データを正しく理解し分析するには、粘着性を考慮する必要がある。
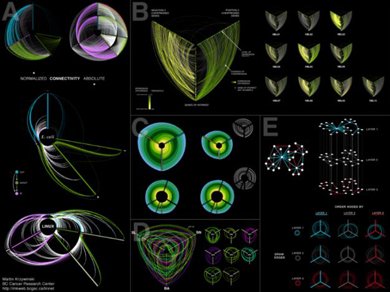 放射線状の線形軸に粘着性を可視化する「Hive Plot」の表示例(出典:Genome Sciences Center)《クリックで拡大》
医療ビッグデータを支えるインフラ基盤の条件
ライフサイエンス分野のデータは削除できないと前述したが、手術映像もその1つだ。保険などの関係で医療機関は、患者の死後10年間、手術映像を保存する必要があるという。 EMCは、こうした課題を解決する手段の1つとして、ストレージ製品「EMC Isilon」(以下、Isilon)を提供している。Isilonでこうしたコールドデータ(利用頻度の低いデータ)とホットデータ(頻繁に使うデータ)とを識別し、ホットデータをすぐに取り出せるようキャッシュ保存することで、蓄積されたナレッジを利用できる環境を構築可能だ。
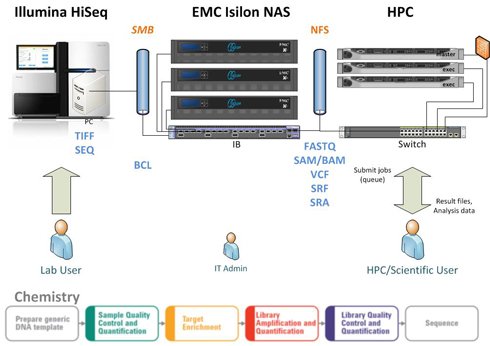 EMC Isilonによる医療ビッグデータ分析基盤の例(ジョシ氏提供資料より)《クリックで拡大》
個人データの取り扱いが、医療ビッグデータ成功のカギ
EMCでは、ビッグデータ活用を進めるためにストレージ基盤は「データの大きな湖」(データレイク)になるべきだというコンセプトを持っている。医療・ライフサイエンス分野でビッグデータ活用を促進するには、取り組むべき課題はさまざまある。ジョシ氏は以下の点を挙げている。
- 大量のデータを異なるデータレイク間で移動させながら情報の一貫性や可用性、セキュリティを担保する
- ビッグデータに対応可能なメタデータの作成
- 10万人以上を対象とした誤検知のないコホート研究(特定の地域や集団を対象に、長期にわたって健康状態や疾病の発生率などを調査し、要因を調べる研究)の実現
中でも大きな問題となるのが、個人の医療データの取り扱いだ。ヘルスケア事業専門の大手ベンチャーキャピタルRock Healthによると、米国の70%の新興企業は臨床データに投資しており、次に多い投資先は患者から提供される医療データだという。健康管理型のウェアラブル端末などの普及で、個人の医療データはますます簡単に収集できるようになった。
その結果、ジョシ氏は「30年以内には現在主流の診療方法は消え、全て情報に基づいた診療方法に置き換わるだろう。外傷は来院が必要だが、少なくとも慢性病の診療方法は来院不要の予防対策が中心となる」と予測する。
また、健康な人の情報が収集できることで、病気になるまでの過程を分析して予防医療に生かすことも可能だ。実際、米国では2億1500万ドルを投資し、100万人以上の健康な人の遺伝子データを収集し、遺伝子が原因となる病気の発見や新薬の開発プロジェクトが始まっている。
 ,
一方で、こうしたデータの取り扱いにはリスクが潜んでいる。ジョシ氏は、優勢な遺伝子の組み合わせで誕生した人間を優遇し、遺伝子操作なしで自然に誕生した人間が迫害される未来を描いた映画『ガタカ』を取り上げ、情報の取り扱い方法を個人に適切に説明するという倫理的・法的規制を整備しなければ、映画を単なるエンターテインメントと笑えない世界が来るかもしれないと警告する。
日本でも、東北大学東北メディカル・メガバンク機構が宮城県で3世代コホート調査を開始し、医療情報の有効活用に向けたナショナルデータベースの構築など医療ビッグデータへの取り組みが始まっている。ジョシ氏は「今後、ますます盛り上がる分野だからこそ、データの利用目的や取り扱いを患者に明確に伝え、同意の有無を求める仕組み、倫理的・法的規制の整備は並行して実施してほしい」と語る。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
新着ホワイトペーパー PR
-
事例
[株式会社キーエンス] PCが苦手でも自動化できる ポポラマーマなど4事例に学ぶ「ナビ搭載型RPA」活用 -
製品資料
[株式会社クレオ] IT部門を“価値創造組織”へ転換 IT管理プロセスの改革で戦略的リソースを確保 -
製品資料
[株式会社クレオ] Excel管理が限界に――ITサービス管理の脱・属人化と運用高度化を実現する方法 -
製品資料
[株式会社クレオ] 西武グループやイオングループも実践 事例に学ぶ「ITサービスデスク業務」改善 -
製品レビュー
[株式会社クレオ] 「使われないITシステム」から脱却 現場が求める業務改善を実現する方法
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
2
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
3
「レガシーシステム・老朽化システムの運用課題と刷新」に関するアンケート
-
4
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
5
1回で分かる:仮想マシンを丸ごとバックアップする「VADP」の仕組み
-
6
脱VMwareか、継続か? 仮想化ソフト主要6製品の運用管理と統制機能を徹底比較
-
7
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
8
セキュリティは「情シス任せ」が過半数 漏えい発生時やSCS評価制度の課題は?
-
9
属人化と入力ミスからの解放 アクティオが日本IBMと挑む「AIで調達自動化」
-
10
IT業界の女性は9割が10年で消える 人材枯渇を招く“見えない壁”の正体
ホワイトペーパーランキング PR
-
1
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
2
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
3
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
4
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
5
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
6
プログラミング不要で誰でも実現できる、ネットワーク運用管理の自動化とは
-
7
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
8
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
9
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
10
生成AIの活用を阻む「5つの壁」とは? AIネイティブ組織へ変革を遂げる方法
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー