




















事業部門と開発部門が持つデータ活用視点の違い
リクルートのビッグデータ分析基盤ができるまで、事業部門と開発部門が共に奮闘(1/2 ページ)
リクルートのサービスで共通に使われる「リクルートID」。ここに集まる膨大なデータを同社はどのように収集、分析し、活用基盤を構築しているのか。機械学習の結果を現場で生かす上での苦労と併せて紹介する。
「ホットペッパー」や「じゃらん」「ゼクシィ」「リクナビ」など数多くの人気サービスを手掛けるリクルートグループ。これらのサービスを支えるデータ基盤と機械学習について、2017年10月に都内で開催されたデータ活用関連イベント「Data Platform Conference 2017」のセッションで当事者が語った。同セッションでは、リクルートグループがどのようにユーザーデータを活用してきたかについて、同グループのシステム開発を手掛けるリクルートテクノロジーズが紹介。事業部門と開発部門とのすり合わせの歴史であり、現場でデータを活用する際に必要な示唆に富んだものだった。
併せて読みたいお薦めの記事
「Data Platform Conference 2017」レポート
主要クラウドのデータ分析サービス
- ビッグデータでも負けられない戦い AWS、Azure、Googleの関連サービスを比較する
- GoogleやAWSが提供する機械学習サービス、ビジネスにどう活用する?
- ビッグデータを高速分散処理するSparkをAWSで動かすと何がすごいのか
クラウドを活用したデータ処理の事例
ライフイベント、ライフスタイルに関わるサービスを横断分析可能
同セッションには、リクルートテクノロジーズのITソリューション統括部から2人の話者が登壇した。リクルートのビジネスモデルと横断データ基盤を紹介する前半を担当したのは、渡部 徹太郎氏だ。
 リクルートテクノロジーズ 渡部 徹太郎氏
リクルートグループの事業領域は主に2つに分けられる。進学や結婚など人生のあらゆるシーンをサポートするライフイベント事業、もう1つは旅行や美容などのライフスタイル事業だ。いずれにおいても共通するのは「エンドユーザーとクライアントがいて、それをいかにうまくマッチングさせるかということに注力している点です」と渡部氏は説明する。
より良いマッチングのために「集客力の向上」「ポイント制度の採用」「マッチング率向上施策の実施」「顧客セグメントレポートを活用したデータ主導の意思決定支援」の4プロセスを最適化しつつ運用する。それが渡部氏らに課された任務だ。そもそもリクルートテクノロジーズは、リクルートグループを横断する組織として生まれた。リクルートグループが提供するサービスに共通で使われる「リクルートID」をベースに、Webサイトを横断的に分析、共通ポイントの付与やサービス間のクロス送客をする組織だ。「そのためにグループ横断で使えるビッグデータの収集、分析、活用基盤を構築し、運用しています」(渡部氏)
リクルートグループはそのデータ分析基盤を使い、じゃらんなどリクルートグループが提供する各サービスのWebアプリケーションからマスターデータとユーザーの行動データを収集、蓄積している。収集したデータは、プログラミング言語「Python」で開発したプログラムなどを使って加工し、データ活用のためのアプリケーション(以下、データアプリケーション)に出力する。データアプリケーションでそのデータを可視化できるようにした他、それぞれの事業部門がビジネスインテリジェンス(BI)ツールからデータ分析基盤へアクセスしたりレポートを作成したりできるようにすることで、データドリブンな意思決定を支援する。
現在、データ分析基盤では50種類以上のサービスから2PB程度のデータを集めているという。データベースの数は160件、テーブルは8000件、サーバが200台という規模だ。そこで実行するジョブは1万件を超え、毎月1億クエリを処理している。約400人が利用し、データアプリケーション開発には87人が携わっている。
データ分析基盤の中心となっているのは、Oracleのデータベースサーバ専用機「Oracle Exadata Database Machine」(以下、Exadata)だ。Webブラウザから収集したデータをExadataに取り込み、個人情報のマスキングや名寄せをする。Adobe SystemsのWeb分析サービス「Adobe Analytics」を使って行動分析した結果をさらに機械学習で分析(属性推定)し、年齢や性別などの属性を推定し、それに応じてWebサイトのUI(ユーザーインタフェース)/UX(ユーザー体験)を改善する。これがパーソナライズやレコメンドの基本的なパターンだ。
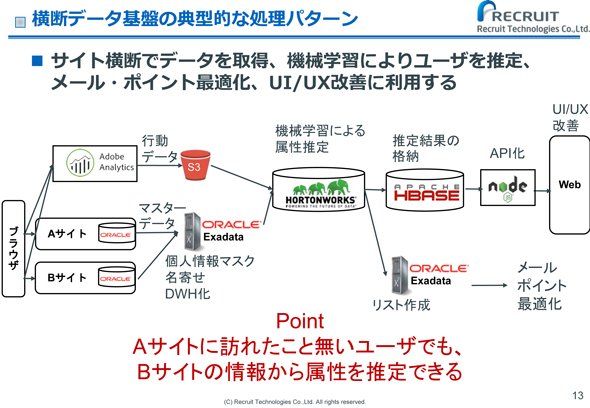 横断データ基盤の典型的な処理パターン《クリックで拡大》
複数のWebサイトを横断したデータ基盤なので「AというWebサイトに始めてアクセスする人であっても、BというWebサイトの利用歴から属性を推定し、ユーザーの意向に沿った情報提供が可能になります」と渡部氏は説明する。
データ分析基盤は十分に完成したシステムに思えるが、まだ課題は多いという。例えば「Amazon S3」の行動データ取得に時間がかかり過ぎていたり、スマートデバイスにインストールして使うネイティブアプリから情報を集め、処理する方法が定まっていなかったりする。ユーザー増加やビッグデータ活用の広まりによる計算量の増大も課題だ。個人情報を扱うデータウェアハウスと機械学習は現在オンプレミスで運用しており、拡張性に限界を感じているという。
データガバナンスのポイントを3点に絞って実例を紹介
続いて渡部氏は、リクルートグループのデータガバナンスへと話題を移した。ポイントはメタデータ管理、データフロー管理、そしてデータ品質管理の3点にあるという。
データの可視化については、該当する機能をWebアプリケーションとして提供し、約4年運用している。主要機能は「データを探す機能」「データの意味を知る機能」「データの変化を知る機能」の3つだ。
データを探す機能としては、データベースやテーブルの一覧を提供するのはもちろんのこと、自然言語検索で必要なデータを含むテーブルを見つけ出せるようにしている。データの意味を知る機能とは、テーブルの定義を事業者側にも分かりやすく提示する機能だ。ユーザーがコメントを残せるようにしており、どのような人がどのようなことに利用したテーブルかを知ることができる。データの変化を知る機能とは、テーブル定義の変化を知るためのもので、変更されるたびにメールで通知を受け取れる。
テーブルへのコメントの応用として、テーブルを頻繁に使う人が見えるようになった。「『このデータについて誰に聞けばいいのか』を可視化できたのです」(渡部氏)
さらに利便性を高めるために「データ収集のハードルを下げたい」と渡部氏は言う。具体的には、利用者自身がデータを追加できる仕組みや、開発者がもっと手軽にデータを追加できる仕組みづくりを目指すという。ビジネス用語とデータのひも付けも進め、データ管理者を置くなど、データ活用の視点も忘れてはいない。
2つ目のポイントは、データフロー管理だ。こちらは入力データとその処理の関係性を管理し可視化するWebアプリケーションを作り、提供している。Exadataと「Oracle Database」をまとめて管理できる仕組みで、取り扱いデータ数は約7000件、ジョブは800件程度だという。データの管理方法には、データ交換形式のYAMLで定義して、バージョン管理システムの「Git」を利用することで、Oracle Databaseのテーブル変更を管理している。主な用途は、障害影響調査など万が一の際のデータ分析だ。
「データの種類や処理目的によって、ソースデータに求められる鮮度が変わります。そのためデータ鮮度を考慮したデータ処理の流れを整備しないと、例えばデータの更新が遅れたときに、どのデータフローに影響があるのかといった障害影響調査が難しくなります」(渡部氏)
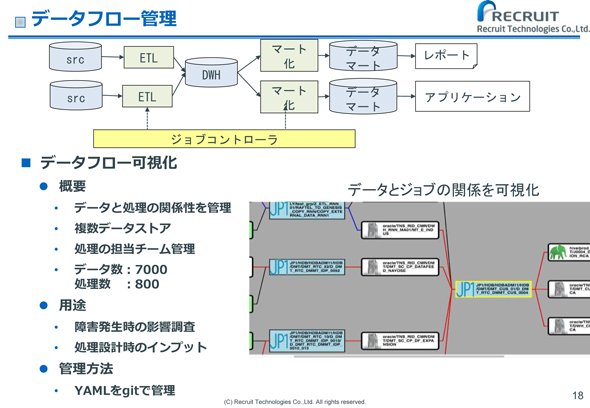 データフロー管理《クリックで拡大》
最後のポイントは、データ品質管理だ。これはまだ課題として残っており、リクルートテクノロジーズでも徹底できてはいないという。各チームが個別に品質チェックをしているのが現状だ。「データごとの品質要件をユーザーが登録し、チェックできる仕組みを作りたいと考えています。分析者がデータの状態を把握できるように、データ品質を標準化する必要があるからです」(渡部氏)
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
市場調査・トレンド
[コパード株式会社] 約9割が負担を実感 Salesforceのテスト業務に関する実態調査で見えた課題とは -
市場調査・トレンド
[コパード株式会社] 「Salesforce」開発・運用におけるAI活用実態調査レポート -
事例
[テクバン株式会社] 1画面でITサービスデスク業務が完結 太陽ホールディングスに学ぶデバイス管理 -
製品資料
[デジタルサーカス株式会社] ライセンス無料 Drupalベースの「多言語ECサイト開発用パッケージ」の実力は? -
製品資料
[デジタルサーカス株式会社] 日本発グローバル企業用Drupal「Risley(リズリー)」の実力とは?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
2
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
3
「企業内サーバ環境の利用実態」に関するアンケート
-
4
OpenAIやAnthropicでさえ制御不能 2026年夏「3大サイバー攻撃」の衝撃
-
5
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
6
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
7
「レガシーシステム・老朽化システムの運用課題と刷新」に関するアンケート
-
8
「業務改善とツール活用」に関するアンケート
-
9
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
10
脱VMwareか、継続か? 仮想化ソフト主要6製品の運用管理と統制機能を徹底比較
ホワイトペーパーランキング PR
-
1
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
2
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
3
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
4
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
5
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
6
プログラミング不要で誰でも実現できる、ネットワーク運用管理の自動化とは
-
7
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
8
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
9
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
10
生成AIの活用を阻む「5つの壁」とは? AIネイティブ組織へ変革を遂げる方法
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー