




















押さえておきたいSQL ServerとHadoop連係の注意点【前編】
SQL ServerユーザーのためのHadoop連係入門
SQL ServerとHadoopの連係でビッグデータ分野に乗り出したMicrosoft。しかしSQL Server用のHadoopコネクタは、SQL Serverのユーザーには取っつきにくいかもしれない。
米Microsoftが「ビッグデータ」の領域に進出する動きを見せている。同社が狙っているのは、米Googleや米Yahoo!などの企業が創業当初から取り組んでいる膨大な非構造化データの分野だ。例えばGoogleでは、毎日20P(ペタ)バイト(2万Tバイト)のデータを処理しており、その大部分はテキストベースのインデックスファイルの形式だ。しかしビッグデータの種類はインデックスだけではない。企業では大量の電子メール、文書、Webサーバのログ、ソーシャルネットワーキングフィード、その他の各種の非構造化情報を日常的に管理している。
GoogleやYahoo!に加え、米Autodesk、米IBM、米Facebookなどの企業では、大量のデータを管理するためにApache Hadoopを採用している。Hadoopは、従来型のツールでは処理できない膨大な非構造化データを管理するためのオープンソースクラウドプラットフォームだ。Hadoopの人気に目を付けたMicrosoftは、自社のSQL ServerとHadoopを接続する技術を開発した(関連記事:マイクロソフトのビッグデータ対応、明かされたSQL Server 2012の新機能)。
Microsoftが最近リリースしたコネクタは、HadoopクラスタとSQL Server 2008 R2やParallel Data Warehouse、あるいは開発中のSQL Server 2012(コードネーム:Denali)との間で大量のデータを移動することを可能にする。これらのコネクタではデータを双方向に移動できるため、SQL Serverのストレージ機能とデータ処理機能を生かしながら、大量の非構造化データを管理するHadoopの機能を利用することが可能だ。
しかしSQL Server用のHadoopコネクタは、SQL Serverのユーザーには取っつきにくいかもしれない。これらはLinux環境に実装されるコマンドライン型ツールなのだ。このため、同コネクタの導入を計画しているSQL Serverユーザーは、それがHadoop環境とどう連係するのかを概念的に把握しておくことが大切だ。
Apache Hadoopクラスタ
HadoopはLinuxコンピュータ上に実装されるマスター/スレーブ型アーキテクチャだ。膨大なデータを処理するには、Hadoop環境に以下のコンポーネントを含める必要がある。
マスターノード
スレーブノードを管理する。データファイルの処理、管理、アクセスに関連したタスクも管理する。さらにマスターノードは、ジョブリクエストをHadoop環境に送信する外部アプリケーションのための一次アクセスポイントとしての役割も果たす。マスターノードはマスターサーバと呼ばれることもある。
ネームノード
ネームノードデーモンを実行する。ネームノードデーモンはHadoop Distributed File System(HDFS)名前空間を管理し、データファイルへのアクセスを制御する。ネームノードはファイルのオープン、クローズ、リネームをサポートする他、データブロックをスレーブノードにどのようにマッピングするかを決定する。小規模な環境であれば、マスターノードと同じサーバ上にネームノードを実装することも可能だ。
スレーブノード
各スレーブノードはデータノードデーモンを実行する。データノードデーモンはデータファイルの保存を管理し、データファイルに対するリード/ライトリクエストを処理する。スレーブノードは比較的低価格で入手が容易なコモディティハードウェアで構成されるので、数千台のコンピュータ上で並列処理を実行することが可能だ。
各種のコンポーネントがHadoop環境内でどのように連係動作するかを図1に示す。マスターノードはジョブトラッカーデーモンを実行し、各スレーブノードはタスクトラッカーデーモンを実行する。ジョブトラッカーはクライアントアプリケーションからのリクエストを処理し、これらのタスクをタスクトラッカーの各インスタンスに割り当てる。タスクトラッカーはジョブトラッカーから指示を受け取ると、データノードと連係して割り当てられたタスクを実行し、処理の各段階でデータの移動を管理する。
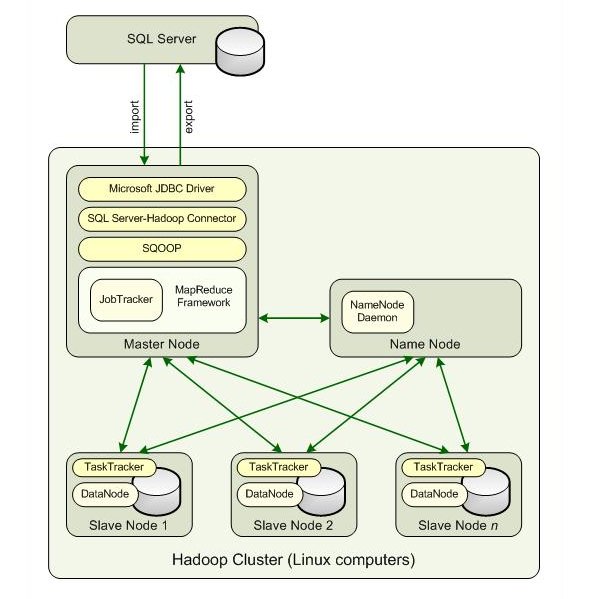 図1:Hadoopクラスタ内にSQL Server用のHadoopコネクタを実装しなければならない
MapReduceフレームワーク
図1に示すように、マスターノードはMapReduce処理を実行するのに必要なフレームワークをサポートする。MapReduce技術はHadoop環境のコア部分に位置する。むしろ、HadoopはMapReduceフレームワークであると見なすこともできる。このフレームワークでは、ジョブトラッカーやタスクトラッカーなどのコンポーネントが重要な役割を果たす。
MapReduceは巨大なデータセットを、管理しやすい小さなチャンク(塊)に分割し、何千台ものコンピュータに分散できるようにする。大規模な並列処理、何P(ペタ)バイトものデータの検索、複雑なクライアントリクエストの管理、掘り下げたデータ分析の実行などに必要なメカニズムも提供する。さらにMapReduce構造は、処理を正確かつ素早く完了するのに必要なロードバランシングとフォールトトレランスも備える。
MapReduceフレームワークは、各ファイルを一連のブロックに保存するHDFSフレームワークと連係して動作する。各ブロックはフォールトトレランスを実現するためにクラスタ内で複製される。1つのファイルを構成するブロックは、最後のブロックを除けば全て同じサイズだ。各スレーブ上のデータノードデーモンは、HDFSと連係してブロックの作成、消去、複製を行う。しかしHDFSファイルは、一度に1つのアプリケーションが1回しか書き込めない。
以上を踏まえ、後編ではSQL Server用のHadoopコネクタの実装手順について解説する。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

新着ホワイトペーパー PR
-
事例
[横河レンタ・リース株式会社] AIの全社活用が加速 トヨタ・コニック・プロに学ぶ「AI PC調達」の秘訣 -
製品資料
[横河レンタ・リース株式会社] 人材不足時代の「PC調達」ガイド:知っておきたいリースとレンタルの違い -
製品資料
[横河レンタ・リース株式会社] PC調達に「レンタル」を選ぶことのメリットは? リース・購入との違いも解説 -
技術文書・技術解説
[セコムトラストシステムズ株式会社] SCS評価制度時代の「SASE選定」ガイド -
比較資料
[セコムトラストシステムズ株式会社] なぜ「SASE選定は難しい」と言われるのか? 多くの人が陥る失敗パターンを解説
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
2
「Wi-Fi 7」経由でWindowsが乗っ取られる? 最高権限奪取の恐怖
-
3
パッチなしで「今すぐサーバを落とせ」 Kiteworks異例警告の波紋
-
4
LINEヤフーはなぜ「社内の管理者」すら信用しないインフラを作ったのか
-
5
「企業におけるAI導入検討度とIT投資優先度」に関するアンケート
-
6
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
-
7
OpenAIやAnthropicでさえ制御不能 2026年夏「3大サイバー攻撃」の衝撃
-
8
「契約業務のAI活用」に関するアンケート
-
9
【基本情報技術者試験】メモリ不足でもアプリが動くのはなぜ? OSを支える「仮想記憶」
-
10
Copilot導入で陥る“目的化”の落とし穴 定着の鍵は「作り込まない」こと
ホワイトペーパーランキング PR
-
1
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
2
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
3
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
4
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
5
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
6
プログラミング不要で誰でも実現できる、ネットワーク運用管理の自動化とは
-
7
Linux初心者でも知らないとまずい「RHEL」「SLES」の違いとは?
-
8
東大教授と考える、AI時代の「データ主権」「信頼性」「ガバナンス」の在り方
-
9
「IT史に名を残すシステム障害」8選
-
10
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー