




















DWH製品紹介:日本テラデータ
全社規模のDWH統合を実現するTeradataの「EDW」構想
DWH専業ベンダーのテラデータがビッグデータ時代のデータ活用基盤として提唱するのが「エンタープライズ・データウェアハウス」(EDW)だ。同社の製品概要と併せてその構想を紹介する。
DWHのパイオニアが提唱する次世代ソリューション「EDW」
データウェアハウス(DWH)の世界で、長らくデファクトスタンダードの地位を占め続けてきたベンダーが米テラデータだ。DWH市場の急激な成長に伴い、今日でこそ数多くのベンダーが市場に参画して激しいシェア争いを繰り広げているが(関連記事:ビッグデータ対応のために進化するDWHアプライアンス)、かつては「DWH」と「テラデータ」はほぼ同義といってもいいほど同社の存在感は圧倒的だった。もちろん今日でも同社はDWH市場におけるトップランナーの地位を維持している。
 日本テラデータの丹 隆之氏
1979年に世界初のDWH専業ベンダーとして産声を上げたテラデータは、以来世界中で約1200社、2500システム以上の導入実績を積み上げてきた。同社の社名「テラデータ」は、「Tバイト級」のデータを扱う意思決定支援システムの実現を目指したことに由来する。しかし現在では、P(ペタ)バイト級のデータを運用するユーザーも珍しくないという。日本テラデータ マーケティング統括部 プロダクト・マーケティング&マネジメント部 部長の丹 隆之氏は、次のように述べる。
「カタログスペック上で“Pバイト級”をうたうベンダーは多いが、実際にそれらの製品のユーザーがそれだけの規模のDWHを運用している例はさほど多くない。しかも、単にPバイト級のデータをため込むだけでなく、それを実際に活用して業務に生かしている例となるとさらに少ない。しかしテラデータ製品のユーザーの中には、実際にPバイト級のデータをビジネスに有効活用している事例が多く存在する。例えば米eBayでは現在、数十Pバイトものデータを運用・活用している」
社内に散在するDWHを1つに集約
そんな同社が現在積極的に提唱しているのが、「エンタープライズ・データウェアハウス」(EDW)と呼ばれる次世代のDWHソリューションだ。2000年代後半、多くの企業が積極的にDWHシステムの構築に乗り出したが、現在その多くで新たな課題が持ち上がっている。それが、社内に散在する複数のDWHの管理だ。社内の各部門のニーズに応じて個別にDWHやデータマートを構築していった結果、それぞれに保管されたデータの内容が重複したり、あるいは整合性が取れなくなってきているのだ。また、同種のシステムが社内に複数散らばっている状況は、運用管理面でも効率が悪い。
こうした問題を解決するために、「社内の情報系システムのデータを全て単一のDWHに集約して、一元管理しよう」というのがEDWのコンセプトだ。テラデータでは現在、このEDWを実現するための製品提供はもちろんのこと、ユーザー企業のEDW構築プロジェクトをサポートするための各種支援サービスも提供している。
「EDWは、製品を導入すれば実現するというものではない。むしろ構築の“プロセス”こそが重要だ。そこでわれわれは、EDWに徐々にデータを足していく段階的な構築プロセスを提唱している」
例えば、まずは受注データをEDWに集約して、全社的な販売分析の仕組みを構築する。これに在庫データを追加すれば、在庫分析はもちろんのこと、受注データと在庫データを掛け合わせたクロス分析も可能になる。さらに需要データを追加すればクロス分析の切り口はさらに増える。つまり、EDWに投資すればするほどそこから得られるビジネス価値はそれ以上に高まっていくことになるのだ。「このような相乗効果を生むことができるプロセスを、顧客とともに実現していきたいと考えている」
DWH用途に特化したデータベースソフトウェア
テラデータでは現在、DWHに対する多様なニーズに応えるために、設計思想が異なる5種類の製品ファミリーをそろえる。それぞれ、異なるシステム規模や用途を想定して最適化したハードウェアプラットフォームを採用するが、その上で稼働するデータベースソフトウェアは全て同じ「Teradataデータベース」が使われている。
Teradataデータベースは、ユーザー側から見ると一般的なリレーショナルデータベースソフトウェアと同じだ。つまり、SQLでデータ操作処理を記述し、それをデータベースに渡せばそこでクエリが実行され、結果セットがユーザーに返される。しかしその内部をのぞいてみると、一般的なリレーショナルデータベースとは異なるアーキテクチャに基づいて作られていることが分かる。
「Teradataデータベースは、一般的なリレーショナルデータベースがターゲットとするOLTPシステムではなく、あくまでもDWHによる意思決定システムの処理最適化にターゲットを絞って設計・開発されている」
DWHシステムのデータベースには、OLTPのそれとはかなり異なる要件が求められる。例えば、クエリの性格。OLTPのデータベースで処理されるクエリは、アプリケーションプログラムにあらかじめ埋め込まれた定型のクエリが中心になる。しかし、DWHのような分析システムの場合は、ユーザーがその都度さまざまな切り口でデータ分析を試みるため、非定型のクエリが中心になる。そのようなクエリは、OLTPの定型クエリを前提に作られたデータベースではなかなか効率的に処理できない。
その点Teradataデータベースは、複数のSMPノードでクエリを並列分散処理するMPP(超並列プロセッシング)技術と、「シェアードナッシング」アーキテクチャの採用により、非定型クエリを極めて高速に処理できるようになっている。各SMPノード上の検索プロセスはそれぞれ専用の記憶領域を持ち、他のプロセスと記憶領域を共有することはない。そのため、ユーザーから送られてきたクエリを各ノードで分散処理する際、ノード間でアクセス競合を起こすことなく、高いスループットを実現できるのである。
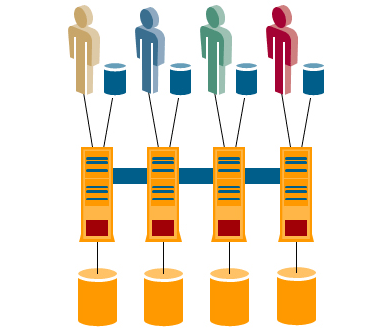 Teradataのアーキテクチャイメージ。完全に各ノードが独立して動作するため、ボトルネックが発生しない
このアーキテクチャは処理性能だけでなく、システムの拡張性や投資対効果の面でも大きなメリットがあると丹氏は言う。
「SMPノード間でリソースを共有せず、完全に各ノードが独立して動作するため、ノードの増設によって線形的にシステムの性能と規模を拡張できる。また、ノードの増設によるパフォーマンス向上を正確に予測できるので、プロビジョニングの精度が上がり、システムに対する無駄な投資を減らすことができる。さらには、テラデータ製品は他社の多くの製品とは異なり、古い機種で構築したシステムに対して、新しい型番のハードウェアを追加できるようになっている。既存環境を生かしながらシステムを順次拡張していけるので、投資対効果をさらに高めることができる」
また、自動チューニング機能により、システムの構築と運用管理に掛かる手間を極力少なくできる点も、テラデータ製品の大きな特徴だという。
「通常DWHを構築する際には、論理モデル設計、物理モデル設計、パーティション設定、テーブル配置設定、データロードといった作業に膨大な手間と時間がかかる。しかしTeradataデータベースでは、論理モデルさえきちんと設計しておけば残りの作業はシステムがほとんど自動的に行ってくれる。また、運用開始後のディスク領域管理やインデックス管理などのチューニング作業もシステムが自動的に行ってくれる。データベース管理者はこうした煩雑な作業から解放され、より戦略性の高い仕事に専念できるようになる」
SSDのメリットを最大限引き出す「Active EDW 6650/6680」
前述の通り、テラデータの製品ラインアップは、ユーザーニーズに柔軟に応えられるよう、DWHシステム全体の規模や性格に応じて5種類のプラットフォームファミリーに分かれている。最も小規模なシステム向けのプラットフォームが「Data Mart Appliance 560」で、主に部門別データマートや開発・テスト用途を前提としている。そして、これより多くのデータを扱うことができるエントリーレベルの製品「Data Warehouse Appliance 2650」、Pバイト級の大容量データ分析を目的とした製品「Extreme Data Appliance 1650」をそろえる。
また、扱うことができるデータ量はさほど多くはないものの、とにかく高速にリアルタイム分析を行いたいというニーズに対しては、ディスクを全てSSD(Solid State Drive)で実装した製品「Extreme Performance 4600」も用意する。
そして、データ容量と処理性能の両面で高い拡張性を持ち、EDWの構築に最適な製品としてテラデータが推奨するのが、同社の主力製品「Active EDW 6650」と「Active EDW 6680」だ。両製品の最大の特徴は、HDDとSDDが混在した「ハイブリッドストレージ」を採用している点だ。ちなみに、Active EDW 6680には初めからHDDとSSDが混在して実装されており、ユーザー領域は最大36Pバイト。一方のActive EDW 6650は、デフォルト状態ではHDDのみでストレージが構成されており、後からSSDを追加できるようになっている。こちらのユーザー領域は、最大92Pバイトまで拡張可能だ。
| Data Mart Appliance 560 | Extreme Data Appliance 1650 | Data Warehouse Appliance 2650 | Extreme Performance Appliance 4600 | Active EDW 6650/6680 | |
|---|---|---|---|---|---|
| 目的・用途 | 部門データマート、テスト・開発向け | 大容量データ分析専用DWH向け | エントリーレベル、意思決定支援システム(DSS)専用DWH向け | オペレーショナル分析のためのSSD100%の超ハイパフォーマンス向け | 全社の戦略、業務インテリジェンスおよびエンタープライスDWH向け |
| 拡張性(※) | ~11Tバイト | ~186Pバイト | ~343Tバイト | ~ 18Tバイト | ~92Pバイト |
| 可用性 | RAID対応 | ホットスタンバイノード対応 | クリーク対応 | クリーク対応 | エンタープライズクラスのミッションクリティカル対応 |
| 多世代ノードの共存サポート | なし | 有り (Co-Residence) |
有り (Co-Residence) |
なし | 有り (Co-existence) |
| サポートOS | Novell SUSE Linux | ||||
| ※非圧縮時 | |||||
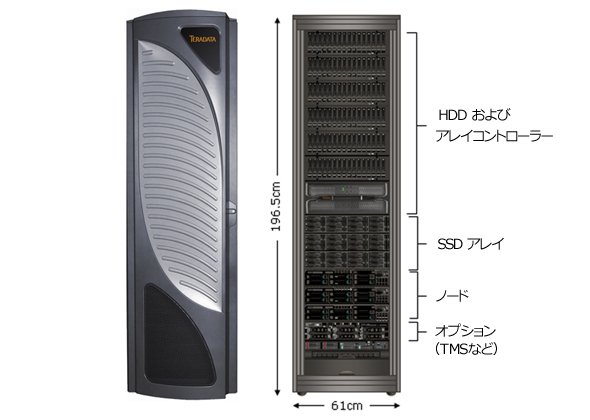 SSDを標準搭載するActive EDW 6680。表面を開けてみると、上半分にHDDとアレイコントローラーが入っており、その下にSSD、さらにその下にノードなどが収まっているのが分かる
SSDは今さら言うまでもなく、HDDよりはるかに高いスループットを実現できる技術として注目を集めており、既に一般的なストレージ製品での採用が進んでいる(関連記事:なぜ企業向けストレージシステムでフラッシュドライブが注目されるのか)。丹氏はDWHにおいてもSSDの導入は極めて効果的だと述べる。
「80%の読み出し処理と20%の書き込み処理を行った際の、SSDと1万5000回転HDDの性能を比較した場合、SSDの方が約22倍の性能を示すといわれている。実はこの『80%の読み出しと20%の書き込み』というワークロードは、DWHの一般的な利用形態に極めて近いため、SSDはDWHと非常に相性が良いといえる」
Active EDW 6650/6680には、SSDのメリットを最大限引き出すためのさまざまな機構が搭載されている。その1つが、「Teradata Virtual Storage」(TVS)と呼ばれる独自技術だ。TVSは、単一のDWHシステム中に異なるサイズ・形式のストレージが混在する環境を効率的に管理するためのストレージ仮想化技術だ。各ストレージの性能を自動判別し、データのアクセス頻度に応じて自動的に最適なデータ配置を行う機能が含まれている。例えば、ロードされたばかりでアクセス頻度が高いデータ、いわゆる「ホットデータ」をスループットの高いSSDに、アクセス頻度が少ないデータ、つまり「ウォームデータ」や「コールドデータ」をHDDに自動的に配置してくれる。
また、ホットデータはいつまでも「ホット」であるとは限らない。データの鮮度が落ちるにつれてアクセス頻度も少なくなり、徐々に「ウォーム」「コールド」とデータの性質も変化してくる。TVSは各データブロックのアクセス頻度を定常的に監視することで、こうしたデータの「温度の変化」も随時チェックし、その都度最適なデータ配置を自動的に行ってくれる。
「最適なデータ配置を自動的に行うため、管理者はほとんど何もせずとも常に最適なスループットを維持できる。TVSは従来のActive EDW製品にも実装できるが、特にSSDとHDDを混在させたActive EDW 6650/6680のシステムにおいて最大の効果を発揮する」
Teradata関連コンテンツ
Hadoopとの連携によるビッグデータ対応
テラデータはDWH専業ベンダーとしてコンサルティングサービスにも力を入れている。数多くのDWH構築プロジェクトを手掛けて培われてきたノウハウを生かしながら、ユーザー企業が抱える業務課題を具体的なDWHソリューションに落とし込んでいくプロセスを、豊富な業務知識を持つコンサルタントが現場でユーザーとともに推進していく。特に、前述のEDWの構築に際しては、独自の方法論を持つという。
「業界別にあらかじめ用意された論理データモデルのテンプレート(LDM:Logical Data Model)を基に、具体的な業務課題の解決のためにはどういうデータが必要になるかを子細に評価していく。その際には、『EDWロードマップ』という独自のツールを使いながら、業務課題とデータの関連付けを可視化していく。このツールの中には、われわれが培ってきたコンサルティングのナレッジがぎっしり詰め込まれている」
また、昨今大きく取り沙汰されるようになった「ビッグデータ」への取り組みをいち早く始めている点も、同社の大きな特徴だ。特に自社製品とHadoopとの連係に関しては、Hadoop技術を有するベンダーとの連携や買収も含め、かなり早い段階から対応に乗り出している。
「構造化データに関しては、テラデータ製品は既にPバイト級の大容量データに対応しており、ビッグデータも問題なく処理できる。一方、非構造化データに関しては、HadoopをETLとして使い、非構造化データを構造化データに変換した上でTeradataに流し込むという連携シナリオを考えている。また、2010年9月から提携している米ClouderaのHadoopディストリビューションとTeradataとを連係させるためのアダプター開発も進めている。さらには、2011年4月に買収したAster DataのSQL MapReduce技術を使った連係の図式も、近い将来描けるのではないかと考えている」
Copyright © ITmedia, Inc. All Rights Reserved.


新着ホワイトペーパー PR
-
製品資料
[o9ソリューションズ・ジャパン株式会社] 「改正物流効率化法対策」徹底解説 総物流費を抑制するサプライチェーン戦略 -
製品資料
[o9ソリューションズ・ジャパン株式会社] 「サプライチェーン最適化」実践ガイド:効果的な意思決定を実現する秘訣とは? -
製品資料
[株式会社リンプレス] 非デジタル/IT人材を「自走するDX推進者」に変えるための育成ロードマップ -
市場調査・トレンド
[ワンアイルコンサルティング株式会社] AI時代の組織設計:「判断と責任」を人に残すための2つの原則とは? -
技術文書・技術解説
[ワンアイルコンサルティング株式会社] システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「AIバブル」は崩壊するのか? 熱狂の後に来る“尻拭い”と4つの防衛策
-
2
「完璧な設計」なのに3000万円溶けた AWSの失敗事例から学ぶ3つの教訓
-
3
パナソニックが国内製造26拠点のERPを「SAP S/4HANA」に統一 アドオン7割削減
-
4
「コピペ運用の限界」に直面するAI活用 7割超が“別画面”のまま使う理由は?
-
5
Microsoft製品でここまで自動化できる 情シスがやめられる手作業10選
-
6
【お知らせ】「クラウドインフラに関するアンケート調査」結果リポート
-
7
自律型AIエージェントの特徴として最も適切なものは?
-
8
守るべきは「開発者のフロー状態」 AIによる生産性改善の6施策
-
9
脱VMwareの前提が崩れる BroadcomのVDDK公開停止で確認すべき点
-
10
データを無断で暗号化し使用者に身代金を要求する詐欺に用いられるマルウェアとは?
ホワイトペーパーランキング PR
-
1
JR西日本ITソリューションズが「監視業務の属人化」を解消した方法とは?
-
2
インシデント対応工数を約3割削減、東京ガスの事例に学ぶ監視体制刷新のコツ
-
3
生成AIで文書活用を進めるには? 効率化と安全性をどう両立する
-
4
Windows PCとMacの選択制で生産性向上 LINEヤフーが実践する運用管理方法とは
-
5
DX/AI投資の壁を突破、現代の最高財務責任者が直面する課題と克服のヒント
-
6
「Google Workspace」活用事例34選、先進の生成AIによる組織変革の全貌
-
7
「人員を増やす」という選択肢はない 情シスが負の連鎖から抜け出すには?
-
8
Linuxのスキルを証明する“激推し”の認定資格はこれだ
-
9
「問題が深刻化しやすいプロジェクト管理」から脱却する方法とは?
-
10
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー