




















組み込み向け半導体最新動向:ARMプロセッサ
ARMアーキテクチャはどのように進化してきたのか?
なぜARMプロセッサは組み込み向けで多く利用されているのか? ARMプロセッサの変遷と特徴を解説するとともに、今後の可能性について触れる。
組み込みを代表するプロセッサの1つ、ARM
組み込みを代表するプロセッサとしてまず挙げられるのがARM(Advanced RISC Machines)であろう。もともとは英Acorn Software Technologies(以下、Acorn)というマイコンのベンダーが、1985年に自社のマイコン用に開発した32ビットRISC(Reduced Instruction Set Computer:縮小命令セットコンピュータ)だった。当時、Acornはモステクノロジーの「6502」というプロセッサをベースにマイコンを作っており、最初のARMプロセッサである「ARM1」は、この6502のエミュレーションを行うことができた。ちなみに、この6502やその後継製品は、今でも米国のWDC(The Western Design Center)で製造されている。
これに続き、「ARM2」「ARM3」とプロセッサが強化されていくにつれて、ARMそのものの方に人気が出てしまう。最終的に、AcornはARMプロセッサの開発部隊のみを残し、コンピュータの開発/生産ラインをAcornのブランドごと売却してしまった。一方で開発部隊は「ARM(アーム)」と改称され、プロセッサの生産だけでなくプロセッサコアのライセンス供与を主要なビジネスに切り替えて現在に至っている。
プロセッサコアのライセンス供与とは、要するに「CPUの設計図を売るビジネス」と考えればよい。つまり、アームは物理的なCPUのチップを一切販売せず、設計図のみを販売している。実際のCPUチップは、この設計図を購入したベンダーが自分で製造する形になる。設計図にもさまざまなものがあり、アームが提供している設計図は以下の3種となっている。
- ハードコア:特定のファウンダリの特定のプロセスでそのまま製造するための設計図
- ソフトコア:ファウンダリやプロセスに関して、ある程度自由度がある設計図
- アーキテクチャ:ハードコアやソフトコアよりもっと上位レベル、すなわち命令レベルの設計図。もちろん、アームがもともと設計したCPUの内部構造をそのまま使うこともできるが、これを自由に変更したり作り直したりすることもできる
ベンダーは自分の欲しいCPUの設計図を購入し、自分で作るようになっている。結果として、PCのように「CPUだけ」で販売されることはなく、最低でもメモリコントローラーやI/Oバス、幾つかの周辺機能を統合したSoC(System on a Chip)の形で製造されることになる。当然、製造プロセスについてもさまざまで、例えば「ARM11」は0.13マイクロメートルから65ナノメートルあたりまで、複数のプロセスで製造された製品が市場に混在している。
ARMプロセッサの用途は変遷してきた
ARMプロセッサ(アームのプロセッサコア)は、命令セット(ARMv1~v7)と実際の製品が複雑な関係になっている。アームが開発したコアを図にまとめた。
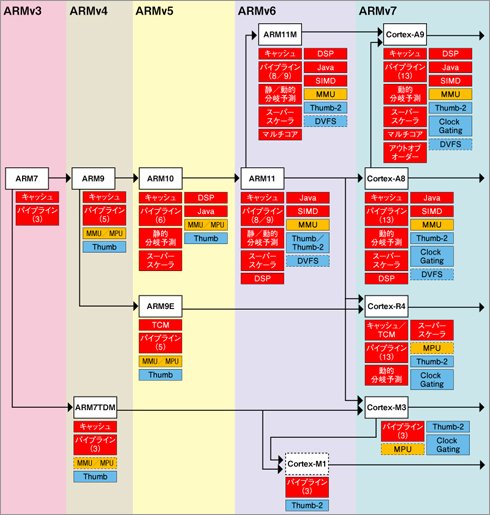
まず、ARMv1/ARMv2に属するのはAcornのマイコン向けだ。そのため、組み込み向けとなるとARMv3に当たる「ARM7」(※)が挙げられる。ARM7は32ビットのプロセッサながら、パイプラインは3段、4~8Kビットのユニファイドキャッシュを搭載し、動作周波数は40MHz前後と小規模なものである。
※厳密にはこの前に「ARM6」があり、アップルの「Newton」をはじめ幾つかの製品で使われたが、広く使われ始めたのはARM7からなので、あえてARM7から説明する
ARM7の後継である「ARM9」と「ARM7TDMI」は、どちらもARMv4という新しい命令セットを搭載しているが、方向付けがはっきり分かれている。ARM9は、パイプライン数増加やMMU(Memory Management Unit)およびMPU(Memory Protection Unit)の実装など高機能化を目指したプロセッサである。それに対し、ARM7TDMIはパイプライン数を3段のままとし、「ARM9と同じプログラムの実行を実現しつつ、より低価格・低消費電力」を目指した。性能的に従来のARM7で足りる用途にはARM7TDMI、より高性能な向きにはARM9という明確なパーティショニングが行われたのだ。
これは、次のARMv5でも同じである。ハイエンドには、6段パイプラインやハーバードアーキテクチャ(命令/データでキャッシュを分割する方式)、静的ながら分岐予測、そしてLSU(Load/Store Unit)の命令をALU(Arithmetic Logic Unit)命令と同時に発行できるスーパースケーラが搭載された。また、DSP(Digital Signal Processor)命令や「Jazelle」(Javaをネイティブ実行できるアクセラレータ命令)が搭載可能になったことで、大幅に性能を引き上げた。一方で、同じARMv5に属しながら、やはり低価格向けを狙った「ARM9E」は、パイプラインは5段のまま留め置かれ、スーパースケーラやDPS/Jazelleなどは搭載していない。しかも、キャッシュの代わりにTCM(Tightly Coupled Memory)を利用したあたりが、ARM9Eの使われ方を示唆している。
ARMv5の段階で、以下のようなポジショニングがなされた。
| 用途 | コア |
|---|---|
| ハイエンドのパフォーマンスが必要な用途 | ARM10E |
| SoCなどに用いられ、ほどほどの性能が必要な用途 | ARM9E |
| やはりSoCなどにも用いられるが、性能よりも消費電力・コストを重視する用途 | ARM7TDMI |
この構図はARMv6でも変わらない。ハイエンドとなるARM11はARM10をさらに高機能化しており、パイプライン数の増加だけでなく、動的分岐予測を備えてスーパースケーラも強化されたほか、SIMD(Single Instruction Multiple Data)演算エンジンも搭載された。また、ARM11をベースに最大4コアまでのマルチプロセッサに対応できる「ARM11MP」も投入されている。加えて、ARM11からはオプション扱いではあるものの、DVFS(Dynamic Voltage/Frequency Scaling)も採用されるケースが出てきた。CPU負荷に合わせて動作周波数と電圧を変化させることで、待機状態の消費電力を下げるという仕組みだ。CPU外部に電圧/周波数を管理する機構や電圧を可変する機構が必要になり高コストになるため、組み込み向けでの採用例はそう多くない。しかし、ARM11クラスのプロセッサともなると待機時の消費電力削減の要求が高く、多少追加コストが掛かってでも消費電力を下げる方が優先される場合がある(例えば携帯電話向けなど)ことに対応したものだ。
Cortexファミリの登場
これに続く世代がARMv7である。この世代から製品名がCortexに変わり、「高性能アプリケーション向け」「リアルタイム制御向け」「SoCといった組み込み向け」という3種類のプロファイルに分かれた。それぞれのプロファイルは以下のような形で、旧来の製品をすべて置き換えるラインアップとなっている。
| プロファイル | 旧来の製品 | Cortexファミリ |
|---|---|---|
| 高性能アプリケーション向け | ARM11 | Cortex-A8 |
| リアルタイム制御向け | ARM9E | Cortex-R4 |
| SoCといった組み込み向け | ARM7TDMI | Cortex-M3 |
ハイエンドである「Cortex-A8」は、13段というかなり長めのパイプラインとなり、必要に応じてさまざまな要素を強化し、性能が大幅に上がっている。どのくらい性能が向上したのか見てみよう。
ARM11は、おおむね1.35DMIPS/MHz程度の性能で、600MHz程度で駆動されるので800DMIPS強の整数演算性能である。対して、Cortex-A8はピークで2.0DMIPS/MHzまで性能が引き上げられ、1GHz程度での動作が可能なため、2000DMIPSまで積み上がる。実に2.5倍もの性能アップであり、実際一昔前のPC向けプロセッサと大差ない性能になっている。さらに、その後継となるCortex-A9ではアウトオブオーダーまで搭載。ピーク性能は2.5 DMIPS/MHzに達している。それ故に内部構造はかなり複雑で、こちらもPC向けプロセッサと大差ない。従ってトランジスタ数も大幅に増え、DVFSだけでは待機時の消費電力削減が不十分になってきた。そこで、内部には全面的にクロックゲーティング(動作に必要ない回路へのクロック供給を止めることで消費電力を削減する手法)を採用している。
一方、「Cortex-R4」はここまでの性能は必要ないというスタンスで、ARM11よりもやや低め(1.6 DMIPS/MHzで300MHz弱)を狙った設計となっている。Cortex-R4はむしろSoCにした場合の制御能力やSoCとの親和性が問われる。これはキャッシュの代わりにTCMが使えることからも明らかだ。
ローエンドの「Cortex-M3」はパイプライン数が3段と少なく、キャッシュやTCMもない。MMUはなく、MPUがオプションで使えるというあたりは、間違いなくARM7TDMIの後継といった位置にある。
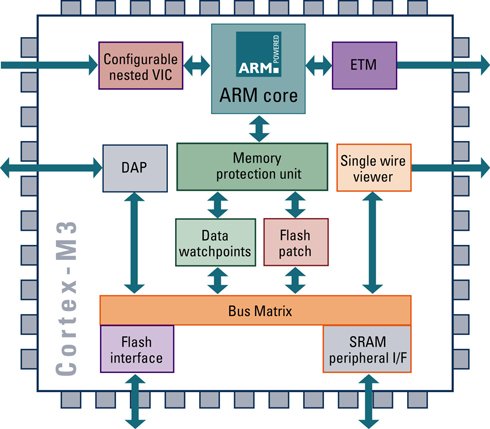
そのCortex-M3のさらにローエンドに位置するのが「Cortex-M1」である。これはSoCなどではなく、FPGA(Field Programmable Gate Array)上で動作するCPUコアという特殊な位置付けの製品となっている。そのため、実行できる命令もCortex-M3のサブセットで、世代的にはARMv6に位置する。
このCortex-Mシリーズで実行できるThumbについては、もう少し説明する必要があるだろう。
ARMの拡張機能は用途によって違うものが採用されている
ARMは基本的に(ARM1の時代から)32ビットのCPUである。従って扱えるデータは当然最大32ビットということになるが、実際にARMコアを使うアプリケーションはもっと小さなデータ量しか扱わない場合がある。有名な例の1つが任天堂の「ゲームボーイアドバンス」である。同製品はARM7TDMIを搭載しているが、実際は8ビット/16ビットのゲーム機として動作している。こうしたケースでは32ビット命令のサポートは不要で、16ビット以下のデータだけが扱えれば十分である。
こうした用途に向けてアームがARMv4で追加した命令体系がThumbである。Thumb命令は一種の拡張命令という扱いだが、16ビット以下のデータしか扱えない代わりに通常のARM命令よりも高い命令密度を実現できる。プログラムサイズをコンパクトにできるため、少ないメモリ容量で動作するのだ。この仕組みのおかげで、ARM7TDMIを使った場合、16ビットクラスのMCUと同等のメモリ量でより高速に動作するといった環境が提供できるようになった。このThumb命令は、その後一部拡張したThumb-2命令に切り替わる(※)。そして、Thumb-2命令を全面的に採用したのがCortex-M3である。Cortex-M3は、Thumb-2命令は実行できるが、32ビットのARM命令はサポートしていない。つまり、実質的に16ビットのMCUと同じということだ。
※この切り替わりはちょうどARMv6のタイミングであったため、ARM11にはThumbに対応したものとThumb-2に対応したものが混在している。
これをさらに推し進めたのがCortex-M1で、FPGA上で動作するため使わないであろう幾つかの命令を省いてしまった、機能限定型のThumb-2である(そのような理由で世代的にはARMv7に達しておらず、ARMv6相当という扱いになっている)。
ARMの地位は揺るがず、より広がりを見せる可能性
ちなみに、ここで挙げたものはあくまでもアームが開発したコアのみである。このような表現をするのは、ARMからアーキテクチャライセンスを受け、自由に拡張を行っているベンダーも幾つかあるためだ。例えば、有名なものではARMv4のライセンスを受けて、スーパーパイプラインを搭載したDEC(※)の「StrongARM」や、StrongARMをDECから買収するとともにARMv5のアーキテクチャライセンスを受けて独自のSIMDエンジンを載せたインテルの「XScale」、同じくARMv5のアーキテクチャライセンスを受け、アウトオブオーダとスーパースケーラを組み合わせたMarvellの「Feroceon」などが挙げられる。細かい部分では、多くのベンダーが独自のアプローチでコアの改良や強化を行っており、一概に語るのは難しい。こうした、非常にさまざまな構成や派生型があるのがARMというプロセッサの特徴といえよう。ARMは現在、最もメジャーなプロセッサの1つであり、今後もARMのアーキテクチャを利用した製品は増えると思われる。
※Digital Equipment Corporation。1998年にコンパックコンピュータ(2002年にヒューレット・パッカードに吸収合併)に買収された。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
新着ホワイトペーパー PR
-
製品資料
[オーティファイ株式会社] AIでコーディングは加速したのにテストはそのまま? いまQAに必要な進化とは -
事例
[オーティファイ株式会社] QAで開発サイクルを遅延させない 8社の事例に学ぶ「テスト工程」の課題解決策 -
製品資料
[株式会社ガラパゴス] 「AIっぽい広告」の山に埋もれさせない AIマーケで着実に成果をだす秘訣とは? -
製品資料
[株式会社ガラパゴス] 「広告投資」調査レポート2026:勝ち組企業は何に投資しているのか? -
製品資料
[株式会社Helpfeel] 「問い合わせの渋滞」を解消、情シスの負担を軽減する“次世代型AI”活用方法
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「Copilot」はなぜ放置される? “議事録要約止まり”を脱する処方箋
-
2
10年かけてBIを再構築したアマノの一手 「権限がない」「予算がない」でもDXは動かせる
-
3
なぜ人はいるのにDXが進まない? ライオンも直面した“老害”レガシーシステム
-
4
急増する「AIはこう言ってる」マン 判断を狂わせる「AI忖度」を防ぐには?
-
5
「Microsoft 365」が乗っ取られる 跡形もなくMFAを破る手口
-
6
9割が頓挫する「AI内製化」 差がついたのはツールより設計力
-
7
AIは「助手」から「攻撃主体」へ 毎月高リスクなAI利用をする企業が9割
-
8
脱VMwareの前提が崩れる BroadcomのVDDK公開停止で確認すべき点
-
9
JSONをやめてPythonで送る トークン消費を約7割抑えるAIの設計
-
10
膨らむAIコストに歯止め GitHubのマルチモデルルーターは何が違うのか
ホワイトペーパーランキング PR
-
1
5回聞くだけじゃ足りない? トヨタ式「なぜなぜ分析」の正しい実践方法
-
2
生成AIで文書活用を進めるには? 効率化と安全性をどう両立する
-
3
AIエージェントで多様な日常業務を効率化するための入門ガイド
-
4
JR西日本ITソリューションズが「監視業務の属人化」を解消した方法とは?
-
5
インシデント対応工数を約3割削減、東京ガスの事例に学ぶ監視体制刷新のコツ
-
6
国税庁の次世代基幹システム「KSK2」稼働開始に向けて、対応すべき変更点とは?
-
7
5分で分かる「セキュア大容量ファイル転送サービス」の機能とメリット
-
8
「スクラム」と「カンバン」の違いとは? アジャイル型開発手法を徹底比較
-
9
ドラマで分かる、標的型攻撃メールの被害を受ける企業と回避できる企業の分岐点
-
10
「脱Excel」か「Excel快適化」か? 現場にやさしい業務改善の進め方
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー