





















AIエージェントの実態を探る【第2回】
データ活用に専門家はもう不要? GoogleのAIエージェントが壊す“属人化の壁”
生成AIやAIエージェントの実用化が進む中で、「専門家の手を借りずに誰もが自律的にデータを扱える時代」が近づいている。Googleが提供するAIエージェントは、分析業務の在り方をどう変えるのか。
「データの民主化」が議論されて久しい。生成AI(AI:人工知能)の実用化が進むことで、自然言語による対話を通して“誰もがAIの力を借りてデータを活用できる世界”が現実味を帯びてきた。
しかし現場では、依然として分析業務の多くを専門家に頼らざるを得ず、データからビジネス価値を引き出すまでに時間がかかるのが実情だ。こうした状況を打開する存在として注目されるのが、自律的にタスクを遂行する「AIエージェント」だ。AIエージェントの活用により、データ活用のハードルは一層下がると期待されている。
Googleは、自律的なデータ分析を実現するAIエージェント群を「データエージェント」として提供する計画だ。企業が抱えるデータ活用の課題は、どこまで解消されるのか。分析業務の在り方は、今後どう変わるのか。
GoogleのAIエージェントが壊す「データ活用の壁」
Googleのクラウド部門Google Cloudでデータ分析領域のカスタマーエンジニアを務める山田裕人氏は「データは持っているだけでは意味がなく、価値に変えてこそ意味がある」と強調する。
 Googleの山田裕人氏
従来のデータ分析業務において、整形されていないローデータ(生データ)のクレンジングや検証には、データベース言語SQLの記述やプログラミング環境Jupyter Notebookでのコード実装が必要だった。そのため、現場の担当者は都度データエンジニアやデータサイエンティストに依頼する必要があり、こうした属人化が業務全体のボトルネックになっていた。
AIエージェントを活用すれば、データのクレンジングから予測モデル作成までの一連の工程を業務部門側が自然言語で完結できるようになる。その結果、データがビジネスの価値に変わるまでのリードタイムは大幅に短縮される。
データ専門家の業務は、定型的な作業やユーザーへの個別対応から「AIエージェントが活躍できる環境づくり」へとシフトしていく。具体的には、AIエージェントが参照するデータ基盤の整備、AIエージェントがデータの意味やコンテキストを理解するためのセマンティックレイヤーの整備、データ品質の改善などだ。
AIエージェント導入の成果は、業務効率化やコスト削減にとどまらない。これまで時間やスキルの制約から困難だった高度な分析が可能になる他、専門家以外もデータにアクセスできるようになり、業務に多様な視点が取り込まれるといった「攻めの価値」も期待できる。
自律型のデータ分析を実現する4つの「データエージェント」とは
山田氏はAIエージェントを構成する3つのコンポーネントについて解説する。
- モデル
- LLM(大規模言語モデル)など、思考を担う“頭脳”の役割。
- ツールズ
- API(アプリケーションプログラミングインタフェース)呼び出しやデータベースアクセスなど、外部とのやりとりを担う“手足”の役割。1つのAIエージェントに複数のツールズが含まれる。
- オーケストレーション
- AIモデルとツールを連携させる“指揮者”の役割。
AIエージェントは、基本的に1つの目的を遂行するよう設計されている。そのため複数のエージェントが連携し、チームとしてタスクを解決するのが一般的な構成となる。こうした複雑な連携を内包しながらも、ユーザーは自然言語で依頼するだけで目的を達成できる。これがAIエージェントの大きな特長だ。
Googleはこうした自律的なデータ分析を担うAIエージェント群を「データエージェント」としてマネージドサービスで提供する計画だ。具体的には以下の4種がある。
- データエンジニアリングエージェント
- データガバナンスエージェント
- データサイエンスエージェント
- カンバセーショナルアナリティクスエージェント
データの前処理を担う「データエンジニアリングエージェント」
データエンジニアリングエージェントは、従来データエンジニアが手動で進めてきたデータ準備作業を代行する。例えば、オブジェクトストレージ「Google Cloud Storage」(GCS)からデータウェアハウス(DWH)「BigQuery」へのデータ取り込みや前処理を自然言語で依頼すれば、自動でデータパイプライン(分析用のデータを準備するための一連の工程)を構築してくれる。
データエンジニアリングエージェントを構成する機能は以下の通り。
- BigQuery Data Preparation
- データの前処理(フォーマットの揃えや欠損値補完など)をGUI(グラフィカルユーザーインタフェース)で実行するための機能。非エンジニアでもデータの前処理が可能になる。
- BigQueryのAI支援機能群「Gemini in BigQuery」の一部として提供される。
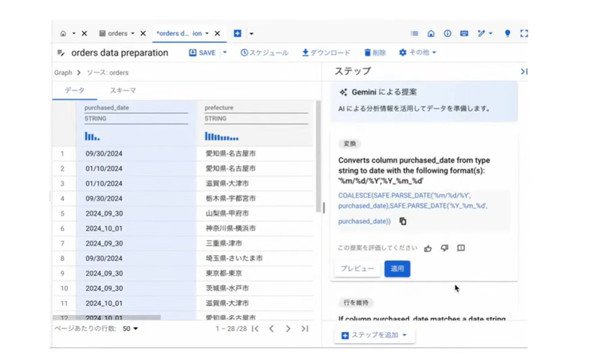 図 エージェントが日付フォーマットのばらつきを検知し、揃えてくれる。(出典:Google Cloud資料)《クリックで拡大》
- BigQuery Pipelines(旧BigQuery Workflows)
- ノーコードでデータパイプラインを構築できるワークフロー管理機能。どのようなデータパイプラインを作りたいのかを自然言語で指示すると、SQLやプログラミング言語Pythonによる複数の処理を組み合わせ、自然言語の指示に従ってパイプラインを自動生成、実行する。
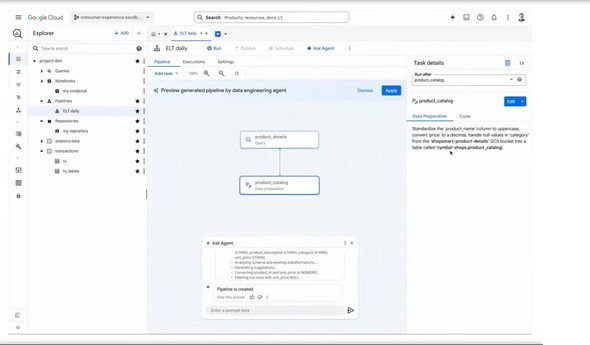 図 「GCSにあるファイルをBigQueryのテーブルに入れて」と指示すると、データパイプラインが自動的に作成される。(出典:Google Cloud資料)《クリックで拡大》
AIエージェントの信頼性を支える「データガバナンスエージェント」
AIエージェントの登場で、従来より多くの人がデータを活用するようになると見込まれる。それに伴い、データガバナンスの重要性は一層高まる。データガバナンスエージェントは、AIエージェントが扱う業務知識(ナレッジベース)や参照権限を管理し、回答の信頼性と一貫性を確保する役割を担う。
データガバナンスエージェントを構成するコンポーネントは以下の通り。
- Automated Metadata Curation(提供予定)
- 生成AI活用においてメタデータの付与は欠かせないが、データ規模が大規模なため、手作業だと工数がかかる。AIモデルがテーブルやカラムに対してメタデータを自動的に付与する。付与されたデータはユーザーが編集可能。
- Anomaly Detection(提供予定)
- データに関する統計情報を取得し、品質をチェックすることで、Null値の急増やユニーク制約の崩れ(一意であるべきカラムの重複)を自動で検知および通知する。
- Google Cloudのデータガバナンス基盤「Dataplex」から取得した統計情報を基に調査する。
モデル開発まで自然言語で依頼できる「データサイエンスエージェント」
AIモデルの構築や実験プロセスを効率化し、分析のスピードと精度を高める役割を担う。具体的には、Jupyter Notebook環境でのデータラングリング(データの整形・加工)やデータ探索(EDA:データの特性や構造の理解)、予測モデル構築といった一連のデータサイエンス業務を支援する。
例えば、「テーブルAのデータをベースに売上予測モデルを作成して。エンジンは『Spark』、モデルは『TimesFM』を使って」と指示すると、Pythonのコードテンプレートを自動生成してくれる。一から書くより工数の削減になり、必要に応じて手直しも可能だ。
壁打ち型の分析を実現する「カンバセーショナルアナリティクスエージェント」
自然言語による対話型のデータ分析を実現し、誰でも分析を使える環境を提供する。単なる質問への回答にとどまらず、グラフの作成、予測、算出したデータの根拠まで出力できる。データ分析ツール「Looker Studio Pro」から利用可能になる計画だ。
カンバセーショナルアナリティクスエージェントは以下のような機能で構成される。
- Conversational Analytics API(提供予定)
- Google CloudコンソールやLooker Studioに入らなくても、使い慣れたSlackなどのチャット形式のユーザーインタフェース(UI)から分析ができる。BigQueryだけでなくLookerのセマンティックモデルを参照できるため、意味を誤解せず、説明可能な分析ができるようになる。
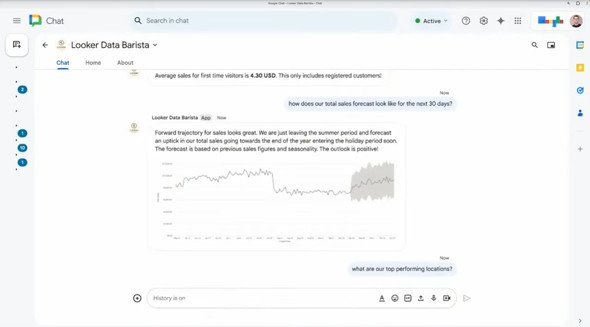 図 Google Chatの画面から「今週の売り上げを基に予測して」と依頼すると、エージェントが回答と併せてグラフも表示。「これは登録されたカスタマーのみが対象です」といった、どのデータに基づいて計算したのか補足説明もしてくれる。(出典:Google Cloud資料)《クリックで拡大》
- BigQuery Knowledge Engine(提供予定)
- 生成AIにとって、「どのテーブルを組み合わせて分析すればいいか」を理解するのは難しい。BigQuery Knowledge Engineは過去のクエリやメタデータを基に、テーブル同士の関係性をER図(データとその関係性を視覚的に表現した図)のように可視化して生成AIによるデータ分析を支援する。
紹介したデータエージェント以外にも、セキュリティ面への懸念から、今後は「自社専用のデータエージェントを社内サーバに構築したい」というニーズも増えてくると山田氏は見込む。Googleのこうしたニーズに応えるため、以下のようなツールを提供予定だ。
- Agent Development Kit(ADK)
- Googleが提供する、企業が独自のAIエージェントを開発するためのフレームワーク。
- MCP Toolbox for Databases
- AIエージェントを外部のデータソースに接続するオープンソースのプロトコル「Model Context Protocol」(MCP)に対応した、データベース接続用ツール群。BigQueryやその他のGoogle製品とAIエージェントを接続するための中間レイヤーとして機能する。
Google Cloudは今後も、データの収集から活用までをエンドツーエンドで支援する製品群を拡充していく方針だ。例えば、データの収集にはデータ連携サービス「DataStream」、蓄積と分析にはBigQuery、データガバナンスにはDataPlex、処理のオーケストレーションにはワークフロー自動化ツール「Composer」を活用する。これらの各ツールとデータエージェントを連携させることで、スピード感のある活用が可能になる。
「データエージェントが登場しても、データ分析の基本的な流れやツール構成が大きく変わるわけではありません」と山田氏は話す。これまで通りの構成にデータエージェントを組み込むことで、各処理の自律化が進み、分析業務全体のスピードや効率が高まる。これこそがデータエージェントの本質的な価値だ。
Copyright © ITmedia, Inc. All Rights Reserved.


AIエージェントの実態を探る
この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社うるる] 「入札市場」攻略ガイド:効率的に落札するためのポイントを徹底解説 -
製品資料
[株式会社うるる] 入札情報に特化した「販路拡大」「効率化」のためのサポートツールとは? -
市場調査・トレンド
[株式会社うるる] 公共入札に成功する企業と失敗する企業の「5つの違い」 -
製品資料
[日本ビジネスシステムズ株式会社] 専門家が教える、Microsoft 365の「テナント統合/分離」を成功に導く秘訣 -
製品資料
[rakumo株式会社] Microsoft 365での情報埋没を防ぐ、社内ナレッジを資産化する情報ポータル活用
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「Microsoft 365」が乗っ取られる MFAを破る“本物の画面”の恐怖
-
2
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
3
PHP脆弱性「PHP2Shell」で2260万件に影響 情シスの緊急チェックリスト
-
4
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
5
テレワークやBYODでリスクが拡大、デバイスの多様化を弱点としない管理方法とは
-
6
「有線LAN環境」に関するアンケート
-
7
「Windows」の不要なファイルを安全に消して容量を空ける方法
-
8
データセンター事業者が「脱VMware」をした“例のライセンス問題”じゃない理由
-
9
「業務改善とツール活用」に関するアンケート
-
10
IBM iのブラックボックス化を打破 資産継承と進化を実現する「IBM Bob」の実力
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
3
2026年のサイバーセキュリティには何が必要か? 最新データに学ぶ傾向と対策
-
4
経験豊富な即戦力人材に直接アプローチできる、「攻めの採用」への転換術
-
5
「IT史に名を残すシステム障害」8選
-
6
SASE選定は「見極め力」で大きな差――本当に必要な製品を選ぶための6つの視点
-
7
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
8
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
9
AI駆動開発のスピードと安全性を両立 「品質・セキュリティ管理」の実践ガイド
-
10
「標的型攻撃メール」事例・サンプル集
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー