




















データセンター環境の物理/仮想リソース管理のコツ(1)
実例で学ぶ、仮想リソース最適化のためのロードバランシング
IT管理者にとってデータセンター環境の適切なリソース管理は必須スキルだ。特に今後重要になるのは、仮想化された物理プラットフォームを考慮したリソースプランニングである。
今日のデータセンターは、堅牢かつ効率的であることに加え、適切に活用されることが何よりも求められる。データセンター環境のリソースがアイドル状態になると、無駄なコストが生じてしまうからだ。しかし、不適切なリソース構成でデータセンターを酷使すると、ハードウェア障害で物理ホストにトラブルが発生する危険がある。そこでIT管理者にとっては、環境全体にわたってコンピューティングリソースを管理、活用することが課題となる。これらのリソースには多くの場合、物理リソース、仮想リソース、クラウドリソースが含まれる(関連記事:システム管理ツールを制するものがデータセンター市場を制す)。
今回から3回にわたり、リソース利用を最適化する手段として、リソースプランニングと問題緩和策について解説する。また、深刻化する前に問題の芽をつみ取る方法も取り上げる。
リソースプランニングのベストプラクティス
現在のほとんどのデータセンター環境では、何らかの仮想化が導入されているか、導入される予定だ。これに伴い、仮想化された物理プラットフォームの展開を考慮することが必要になっている(関連記事:普及期に近づくも運用管理ノウハウに課題が残るサーバ仮想化)。今ではわれわれは、1台のハードウェアプラットフォームにコンピューティングリソースを依存する仮想マシン(VM)群を多数運用しているからだ。これらのリソースにはCPUやメモリ、ネットワークトラフィックのI/O(および、場合によってはディスクトラフィックのI/O)などがある。リソースの管理と問題の特定に関して言えば、プロアクティブなプランニングが適切なリソース活用に役立つ。
「リソース管理」関連記事
リソースのロードバランシング
仮想環境と物理環境のどちらを運用する場合でも、どのようなリソースが使われているか、それらのリソースがどのVMに割り当てられているかを把握することが重要だ。例えば、8コアと24GバイトのRAMを搭載する1台の物理ホストを持っている場合、エンジニアは、使用可能なリソースを全て使おうとはしないだろう。調整や障害対応の余地がなくなるからだ。
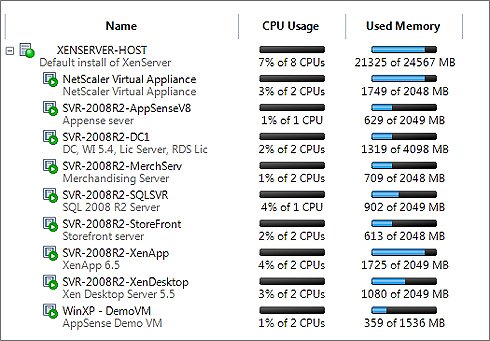 (図1)米Citrixのサーバ仮想化ソフトウェア「Citrix XenServer 6.0 Enterprise Edition」をインストールした1台のマシンが、ローカルストレージのみを使用するホストとして構成されている。小規模な環境ならこれでよいが、ビジネスの変化に伴って、より多くのホストが必要になる可能性がある
上記の例では、1台のXenServerホスト上でエンドユーザーに対して実行されているワークロードの幾つかで、リソース使用率が高くなっている。このソリューションは当面は機能するだろうが、一連のワークロードを実行している仮想サーバの負荷が急増した場合や、仮想サーバを追加する必要が生じた場合に、調整を行う余地がほとんどない。これらの場合、エンジニアは1台の物理マシン上でリソースの需要増加に対応するために、他のVMから仮想リソース(この例ではRAM)を振り向けなければならないだろう。
物理リソースは、全てのVMに必要に応じて提供されるようにしなければならない。どのような環境でも、緊急時やシステム拡張に対応する余地を残しておく必要がある。そこで出番となるのが「ロードバランシング」と「VM管理」だ。
仮想サーバと物理サーバの両方に、適切なタイプのリソースを割り当てる必要がある。リソースを大量に使用するワークロードを展開するときは、それらを実行する各VMに、リソースを計画的に提供し、他の仮想ワークロードや物理ワークロードに影響を与えないようにしなければならない。図2のように、先述のシナリオと同様のハードウェア仕様を持つセカンダリ物理ホストを追加して、物理リソース要素と仮想リソース要素のロードバランシングに着手することができる。
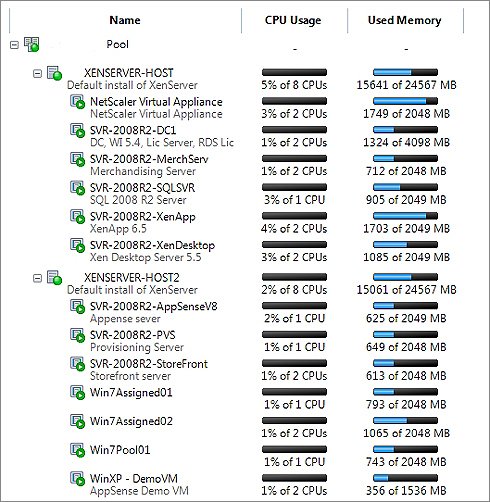 (図2)XenServer 6.0 Enterpriseでは、複数のXenServerホストで構成されるリソースプールを作成できる。このプールではリソースが共有される。実行中のVMを、SANバックボーンを介してホスト間で動的に移行できるからだ
この新しいシナリオでは、2台の物理ホストで構成されるリソースプールにおいて、VM間でリソースが共有されている。実運用される全ての環境は、どれ1つとして同じものがないため、物理リソースのロードバランシングプロセスは、ケースバイケースで個別に計画しなければならない。この例の2台の物理ホストは、既存のVMの要求に余裕を持って対応できる豊富なリソースを持っている。この環境では、VMのアジリティが保証されるようにCPUやRAM、ストレージについて高い要件が設定されている。
また、多くの環境では、高可用性(HA:High Availability)を実現するためにロードバランシングを行うことが求められる。XenServer 6.0を例に見ると、ビルトインツールがこのプロセスに役立つ。XenServerプール(XenServerで作成されたリソースプール)のHA機能を利用すれば、管理者は、あるホストから別のホストにどのVMを安全にフェイルオーバーできるかを把握できる。さらに、エンジニアは、その処理のために物理マシンごとにどれだけのリソースが必要かを判断できる。
ここで留意すべき最も重要なことは、これら2台のサーバ間でロードバランシングが行われ、VMの新規作成、フェイルオーバー、ワークフロー自動化のためにリソースが提供されることだ。HAに関しては、物理サーバの1台で障害が発生すると、もう1台がそのホストの重要なVMを引き継げる。
マシン間でリソースのロードバランシングが行われていると、VMを物理ホスト間で必要に応じて、現在のリソース状態に影響を与えずに移動できる。ディザスタリカバリ(DR)の例を考えてみよう。こうしたロードバランシングのシナリオでは、物理ホストで障害が発生した場合、VMは、リソースが見つかる別の使用可能なホストに移行される。マシンのいずれかが完全に使用されていると、DRやフェイルオーバーは不可能になる。そのサーバでは、移動してくるVMをサポートするのに使用可能なリソースがないからだ。
次回は、ワークフロー自動化やアラート監視などの管理機能を紹介しよう。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

新着ホワイトペーパー PR
-
製品資料
[o9ソリューションズ・ジャパン株式会社] 「改正物流効率化法対策」徹底解説 総物流費を抑制するサプライチェーン戦略 -
製品資料
[o9ソリューションズ・ジャパン株式会社] 「サプライチェーン最適化」実践ガイド:効果的な意思決定を実現する秘訣とは? -
製品資料
[株式会社リンプレス] 非デジタル/IT人材を「自走するDX推進者」に変えるための育成ロードマップ -
市場調査・トレンド
[ワンアイルコンサルティング株式会社] AI時代の組織設計:「判断と責任」を人に残すための2つの原則とは? -
技術文書・技術解説
[ワンアイルコンサルティング株式会社] システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
1200万円のSaaS導入を回避 スギ薬局「運用費10万円」のAIエージェント構築術
-
2
「完璧な設計」なのに3000万円溶けた AWSの失敗事例から学ぶ3つの教訓
-
3
クラウド資格コレクターは評価されない? 年収1000万を分ける“OSの理解度”
-
4
100億円の「Linux更新」を回避 みずほ銀行が選んだ“おきて破り”のRHEL延命策
-
5
高額な「AI PC」を一般従業員も使えたら? 費用のハードルを一気に下げる方法
-
6
「コピペ運用の限界」に直面するAI活用 7割超が“別画面”のまま使う理由は?
-
7
LLMの「過学習」、正しく説明している文章はどれ?
-
8
「AIバブル」は崩壊するのか? 熱狂の後に来る“尻拭い”と4つの防衛策
-
9
2035年までに1億4500万台、急拡大する「フィジカルAI」市場の勝者は誰か
-
10
IT調達担当者が知るべき「IT機器 大インフレ時代の前向きな選択肢」
ホワイトペーパーランキング PR
-
1
インシデント対応工数を約3割削減、東京ガスの事例に学ぶ監視体制刷新のコツ
-
2
JR西日本ITソリューションズが「監視業務の属人化」を解消した方法とは?
-
3
Windows PCとMacの選択制で生産性向上 LINEヤフーが実践する運用管理方法とは
-
4
DX/AI投資の壁を突破、現代の最高財務責任者が直面する課題と克服のヒント
-
5
「Google Workspace」活用事例34選、先進の生成AIによる組織変革の全貌
-
6
生成AIで文書活用を進めるには? 効率化と安全性をどう両立する
-
7
「人員を増やす」という選択肢はない 情シスが負の連鎖から抜け出すには?
-
8
「問題が深刻化しやすいプロジェクト管理」から脱却する方法とは?
-
9
Linuxのスキルを証明する“激推し”の認定資格はこれだ
-
10
NTTドコモが実践したクラウド統合監視 業務量2倍でも残業削減を実現できた理由
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー