





















仮想環境のHAクラスタ製品 選定ポイント【第3回】
VMware環境のHAクラスタ製品の選び方 ~vSphere HA編
VMware環境のHAクラスタ方式の1つである「vSphere HA」の動作、推奨設計・運用を紹介する。また、もう1つの方式の「仮想マシン間HAクラスタ」方式と比較したメリット/デメリットにも着目する。
本連載「仮想環境のHAクラスタ製品 選定ポイント」の前回「VMware環境のHAクラスタ製品の選び方 ~仮想マシン間HAクラスタ編」までの記事において、VMware環境では下記の3つのHAクラスタ方式があることを紹介した。
(1)仮想マシン間HAクラスタ
(2)vSphere HA
(3)vSphere HA+アプリ監視
前回に引き続き、第3回の今回は、VMware環境のHAクラスタ方式の選定を行うために必要な知識として、「(2)vSphere HA」の「動作」「メリット/デメリット」「推奨する設計・運用」についてまとめていく。
これまでの連載
連載インデックス:仮想環境のHAクラスタ製品 選定ポイント
(2)vSphere HA
動作
vSphere HAのアーキテクチャは、仮想マシン間HAクラスタのそれとは大きく異なる。ESXサーバが停止すると、その上で動作していた仮想マシンが別のESXサーバで起動する。
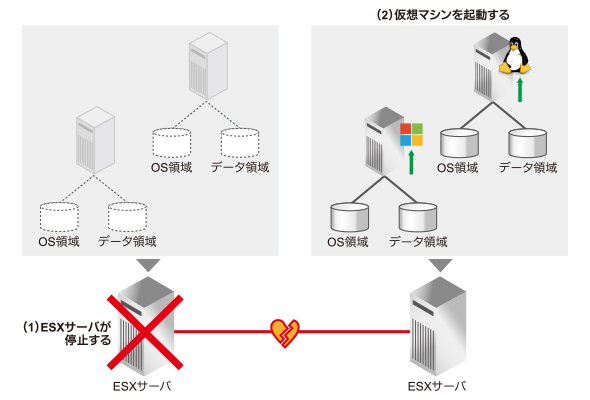 図1 vSphere HAの動作概要
仮想マシン間でアプリケーションが切り替わるのではなく、仮想マシンそのものが別のESXサーバへ切り替わる(フェイルオーバーする)。そのため、個々の仮想マシンは自分のデータ領域を持つだけでよく、複数の仮想マシンから参照するための共有データ領域は不要である。また、vSphere HAのハートビートにはVMwareの管理ネットワーク(※1)が使用されるため、仮想マシン間HAクラスタのように、個々の仮想マシン間のハートビートは不要である。
※1 vCenterに登録されているESXサーバのホスト名で名前解決されるIPアドレスが属しているネットワーク。
vSphere HAのハートビートは、ESXサーバのマスター~スレーブ(※2)間で行われる。ハートビート切断時に、ハートビートネットワーク障害なのか、ESXサーバ障害なのかを区別するため、データストアをもう1つのハートビートとして使用する。また、ハートビート切断時に、ネットワーク障害の影響範囲を確認するping確認先のIPアドレスを「隔離アドレス」と呼び、デフォルトの設定ではデフォルトゲートウェイのIPアドレスになっている。
※2 vSphere HAの機能が有効化されると1台のESXサーバがマスターとして選出され、残りのESXサーバはスレーブとなる。マスターは全スレーブの監視や、vSphere HAの構成管理を行う。
vSphere HAにおけるESXサーバの死活監視は下記の流れで行われる。
1.ESXサーバ間のハートビートが疎通できることを確認
2.データストアハートビートへロックできていることを確認
3.隔離アドレスへpingが到達できることを確認
ESXサーバ停止障害は分かりやすいが、その他の障害については、障害の箇所や状況によって動作が異なるので、きちんと理解する必要がある。以下に4つのケースについて動作を説明する。図2(各4つの図)のそれぞれのケースにおける右側のESXサーバ(スレーブ2)に着目して、動作を確認していただきたい。
ケース1:ネットワークパーティション状態
ケース2:隔離状態
ケース3:ESXサーバ停止
ケース4:ESXサーバとデータストア間の経路障害
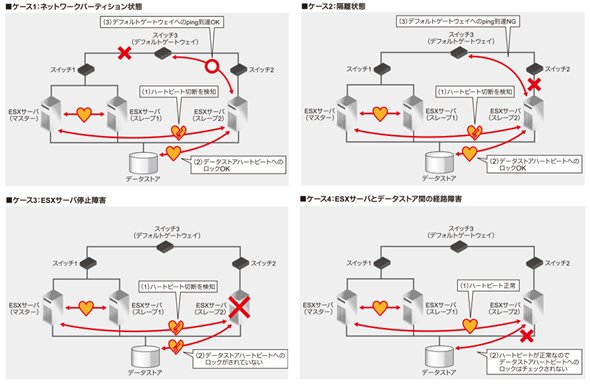 図2 ケース1~4《クリックで拡大》
ケース1:ネットワークパーティション状態
スイッチ1~スイッチ3間のネットワーク障害が発生すると、下記の流れで確認が行われる。
1.マスター~スレーブ2間のハートビート切断を検知
2.スレーブ2からハートビートデータストアへロックされていることを確認
3.スレーブ2から隔離アドレスへはpingが到達できることを確認
マスターとのハートビートは切断されるが、スレーブ2から隔離アドレスへpingが到達するため、スレーブ2とその周辺の環境は健全と判断される。すなわち「ネットワークパーティション状態」である。そのため、スレーブ2上の仮想マシンのフェイルオーバーは行われない。
ケース2:隔離状態
スイッチ2~スレーブ2間のネットワーク障害が発生すると、下記の流れで確認が行われる。
1.マスター~スレーブ2間のハートビート切断を検知
2.スレーブ2からハートビートデータストアへロックされていることを確認
3.スレーブ2から隔離アドレスへはpingが到達できないことを確認
マスターとのハートビートは切断され、スレーブ2から隔離アドレスへのpingが到達しないため、スレーブ2は孤立したと判断される。すなわち「隔離状態」である。隔離状態で仮想マシンをフェイルオーバーするかは、vSphere HAの「ホスト隔離時の対応」の設定による。デフォルトでは、スレーブ2上の仮想マシンのフェイルオーバーは行われない。
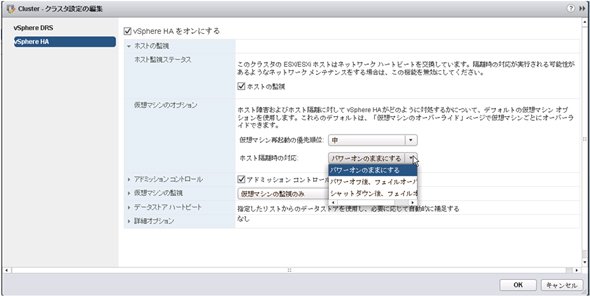 図3 ホスト隔離時の対応。「パワーオンのままにする(デフォルト)」「パワーオフ後、フェイルオーバー」「シャットダウン後、フェイルオーバー」の3つから選択可能《クリックで拡大》
上記でいう隔離状態はESXサーバの管理ネットワークに関して隔離されているか否かで、仮想マシンがサービスに使用しているネットワークに関してではない。そのため、NIC障害時における仮想マシンのフェイルオーバーのために、安易にフェイルオーバーする設定にすべきではない。ESXサーバの管理ネットワークは隔離されている状態でも、仮想マシンのネットワークに影響が無いケースも十分に考えられるからだ。
ケース3:ESXサーバ停止
ESXサーバ(スレーブ2)の停止障害が発生すると、下記の流れで確認が行われる。
1.マスター~スレーブ2間のハートビート切断を検知
2.スレーブ2からのハートビートデータストアへロックがされていないことを確認
マスターとのハートビートは切断される上、スレーブ2からデータストアハートビートがロックされていないため、「ESXサーバ停止」と判断される。そして、スレーブ2上の仮想マシンのフェイルオーバーが行われる。
ケース4:ESXサーバとデータストア間の経路障害
スレーブ2~データストア間の経路に障害が発生しても、マスター~スレーブ2間のハートビートは正常なため、vSphere HAは障害と判断しない。
まとめると下記のようになる。
| 障害内容 | vSphere HAの動作 |
|---|---|
| ESXサーバ停止障害 | 仮想マシンを別のESXサーバへフェイルオーバーが行われる |
| NIC障害 (管理ネットワーク) |
デフォルトは仮想マシンのフェイルオーバーは行われない。「ホスト隔離時の動作」の設定で、仮想マシンのフェイルオーバーを行うことは可能 |
| NIC障害 (仮想マシンネットワーク) |
検知できない |
| ネットワークスイッチ障害 (管理ネットワーク) |
隔離アドレスへのping OK→仮想マシンのフェイルオーバーは行われない 隔離アドレスへのping NG→デフォルトは仮想マシンのフェイルオーバーは行われない。「ホスト隔離時の動作」の設定で、仮想マシンのフェイルオーバーを行うことは可能 |
| ネットワークスイッチ障害 (仮想マシンネットワーク) |
検知できない |
| ESXサーバとデータストア間の経路障害 | 検知できない |
| 仮想マシンのハングアップ | デフォルトは検知できない。仮想マシン監視を有効にすると、同一ESXサーバ上で仮想マシンをリセット。本稿の「ハングアップ」の定義は後述 |
| 仮想マシンの電源停止 | 検知できない |
| 仮想マシン内のアプリケーション障害 | 検知できない |
また、vSphere HAには、「仮想マシンの監視」というオプションがある。デフォルトは「無効」であり、ESXサーバの監視のみを行い、仮想マシンの監視は行われない。そこで、「仮想マシン監視のみ」、または「仮想マシンとアプリケーションの監視」に設定することで仮想マシンを監視することができる。3つ目の「仮想マシンとアプリケーションの監視」については、第4回「VMware環境のHAクラスタ製品の選び方 ~vSphere HA+アプリ監視編」で紹介する。
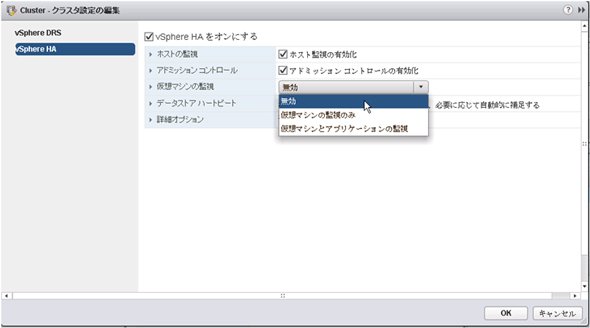 図4 仮想マシンの監視オプション《クリックで拡大》
仮想マシンの監視は、ゲストOSにインストールされているVMware ToolsからのハートビートおよびI/Oアクティビティ(ディスク、ネットワークへの読み書き)を監視する。ただし、仮想マシンの電源停止は、障害によって起きたのか、管理者が意図的に行ったのか区別ができないため、障害と判断されない。
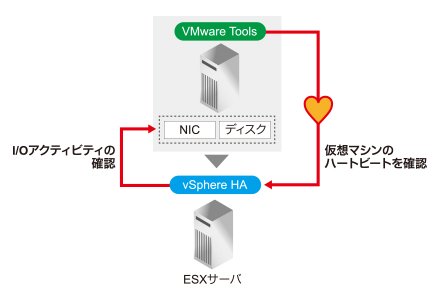 図5 仮想マシン監視の概要
デフォルトの設定では、VMware Toolsのハートビートを30秒間受信しないと、I/Oアクティビティを確認する。120秒間I/Oアクティビティが無い場合、該当の仮想マシンを同一ESXサーバ上でリセットする。仮想マシンのリセットは再起動(リブート)ではない。ゲストOSのシャットダウン処理は行われず、アプリの停止も行われないまま電源がオン/オフされる。また、異なるESXサーバへ仮想マシンが切り替わるのではなく、同一のESXサーバ上で仮想マシンが起動する点にも注意が必要だ。
ここで、ゲストOSのハングアップを「仮想マシンの電源が入っているが、ネットワークI/OもディスクI/Oも行われていない状態」と定義するのであれば、この仮想マシン監視によって、ゲストOSのハングアップを検知できるといえるだろう。
メーカーのドキュメントによっては、上記の動作の中で行われる仮想マシンのリセットを「仮想マシンの再起動」と記述している場合がある。その他、「仮想マシンの停止」についても、仮想マシンの電源まで停止しているのか、電源が入った状態でWindowsのブルースクリーンで固まっているような状態も指すのかなど、仮想マシンの「停止」「再起動」「ハングアップ」「障害」などの言葉については、定義を明確に確認することで誤解を防ぐことができる。
メリット
以下、仮想マシン間HAクラスタと比較したメリットである。
- VMwareの標準機能である
- Windows/Linuxを一元管理できる
- 構成がシンプルである
- 待機系用の仮想マシン、仮想マシン間の共有データ領域、ハートビートネットワークのそれぞれが不要となる
デメリット
以下、仮想マシン間HAクラスタと比較したデメリットである。
- 仮想マシンが使用しているサービス用ネットワークのNIC障害を検知できない
- ESXサーバとデータストア間の経路障害を検知できない
- 仮想マシンの電源停止が検知できない
- 仮想マシン上のアプリケーション障害を検知できない
推奨する設計、運用
仮想マシン間HAクラスタ対象の仮想マシンはvSphere HAの対象から外し、vSphere HAのデフォルト設定での動作を理解した上で、下記のパラメータ変更を検討する。
- ホスト隔離時の対応
- 隔離アドレス
- アドミッション(※3)
- 仮想マシン監視
※3 フェイルオーバー先のESXサーバの指定やシステムリソースを確保する仕組み。本連載では言及しない。
ただ、バックアップ製品によっては、vStorage API for Data Protection(VADP)仮想マシンのリストアで仮想マシンの削除を行ってからリストアするものがある。その場合、一旦、仮想マシンがvCenterのインベントリから削除されるため、その仮想マシンに個別に設定していたvSphere HAの設定が、そのクラスタのデフォルト設定になってしまうので注意が必要だ。
今回は、VMwareの標準機能であるvSphere HAの動作について詳しく紹介した。vSphere HAは、仮想マシン上のアプリケーションの監視ができないことは皆さんご存じのことと思う。だが、ハードウェア障害については、もう少し多くのケースで障害を検知でき、仮想マシンのフェイルオーバーが行われると想像されていた方も多かったのではないだろうか。
vSphere HAの動作を正しく理解した上で、「仮想マシン間HAクラスタ」や、次回紹介する「vSphere HA+アプリ監視」の方式の併用を検討いただきたい。
Copyright © ITmedia, Inc. All Rights Reserved.


仮想環境のHAクラスタ製品 選定ポイント
この記事の著者
関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社うるる] 「入札市場」攻略ガイド:効率的に落札するためのポイントを徹底解説 -
製品資料
[株式会社うるる] 入札情報に特化した「販路拡大」「効率化」のためのサポートツールとは? -
市場調査・トレンド
[株式会社うるる] 公共入札に成功する企業と失敗する企業の「5つの違い」 -
製品資料
[日本ビジネスシステムズ株式会社] 専門家が教える、Microsoft 365の「テナント統合/分離」を成功に導く秘訣 -
製品資料
[rakumo株式会社] Microsoft 365での情報埋没を防ぐ、社内ナレッジを資産化する情報ポータル活用
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
「Microsoft 365」が乗っ取られる MFAを破る“本物の画面”の恐怖
-
2
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
3
PHP脆弱性「PHP2Shell」で2260万件に影響 情シスの緊急チェックリスト
-
4
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
5
テレワークやBYODでリスクが拡大、デバイスの多様化を弱点としない管理方法とは
-
6
「有線LAN環境」に関するアンケート
-
7
「Windows」の不要なファイルを安全に消して容量を空ける方法
-
8
データセンター事業者が「脱VMware」をした“例のライセンス問題”じゃない理由
-
9
「業務改善とツール活用」に関するアンケート
-
10
IBM iのブラックボックス化を打破 資産継承と進化を実現する「IBM Bob」の実力
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
3
2026年のサイバーセキュリティには何が必要か? 最新データに学ぶ傾向と対策
-
4
経験豊富な即戦力人材に直接アプローチできる、「攻めの採用」への転換術
-
5
「IT史に名を残すシステム障害」8選
-
6
SASE選定は「見極め力」で大きな差――本当に必要な製品を選ぶための6つの視点
-
7
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
8
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
-
9
AI駆動開発のスピードと安全性を両立 「品質・セキュリティ管理」の実践ガイド
-
10
「標的型攻撃メール」事例・サンプル集
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー