




















代替技術は生まれるか?
クラウド化で議論が進む「ファイルシステム限界論」
非構造化データの爆発的な増加やクラウドのような技術の普及を受け、従来のファイルシステムで対応できるのかという疑問が出ている。
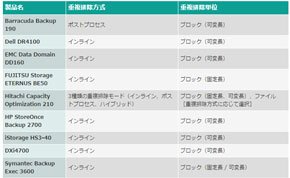 主要バックアップアプライアンスの重複排除方式(参照:【徹底比較】エントリー向け重複排除バックアップアプライアンスの機能と導入コスト)《クリックで拡大》
基本から始めよう。ファイルシステムにはさまざまなものがある。一部のストレージメディアに特化したものもあれば、ネットワークに接続された特定のタイプのストレージデバイスへのアクセスを提供するものもある。前者の例として光ディスク用の「ISO 9660」ファイルシステムなどがあり、後者の例としてNFS(Network File System)、CIFS(Common Internet File System)、SMB(Server Message Block)などがある。また、1つのファイルデータおよびメタデータスキーマを全く異なるファイルおよびメタデータスキーマに変換、あるいはマッピングするファイルシステムもある。こうしたファイルシステムは、物理メディア上におけるファイル解析に関与している。
関連記事
ストレージのトレンドを知る
非構造化データについて
重複排除とは?
重複排除バックアップアプライアンスの記事
要するに、従来のファイルシステムは一筋縄ではいかないということだ。ユーザーファイルを指すことが多い“非構造化データ”の扱いに難があるといわれていることを考えればなおさらだ。実際、従来のファイルシステムは構造がさまざまで、非常に複雑だ。
最近のITの潮流を背景に、ストレージ管理者やデータセンターに関する意思決定者の一部からは、「現行のファイルシステムは本当に今でも、データ保存の最高のメカニズムなのか」という疑問の声が上がっている。実のところ、クラウドコンピューティングや仮想化、“ロングブロック”ファイル(動画、医療画像、ヒトゲノムデータなど)が広く利用されるようになってきたことを受け、既存ファイルシステムの近い将来における有効性が疑問視され始めている。
それはなぜか。第1に、クラウドコンピューティングでは、ディレクトリ構造をフラット化し、1つの名前空間に小さなファイルを大量に配置して、グラフィカルインタフェースなどのように高速にロードすることを目指す傾向があるからだ。場合によっては、1つのページに数百万のファイルコンポーネントが含まれることもあり、そうなれば、データをCPUやGPUに渡すファイルシステム操作を高速化する必要がある。
そしてもちろん、数百万や数十億のファイルをストレージ(今ではTバイトクラスやPバイトクラスが一般的)に展開する可能性がある場合、メディア上に配置され、ノードとiノード(inode)で場所が表される入れ子構造のディレクトリから1つのファイルを検索する速度は、非常に遅くなる恐れがある。
もう1つの大きな問題として、従来のファイルシステムの自己破壊的な特性が挙げられる。ほとんどのファイルシステムは、ユーザーがファイルの新しいバージョンを保存するたびに、その更新のジャーナル(記録)を作成するのではなく、その直前のバージョンを上書きする。これは設計上、慎重に選択された手法であり、ディスクのGバイト単価が法外に高かった30年近く前の時代を反映している。一部のファイルシステムはジャーナリングなど、さまざまなファイル保存オプションを提供しているが、広く使われていない。
例えば、ジャーナリングは、ストレージの無駄使いを防ぐのに役立つと考えられていた。しかし、実は逆効果をもたらしている。エンドユーザーが作成したファイルの内容やビジネスコンテキストを理解するのが難しいことから、ストレージメディア上の容量の浪費に拍車が掛かっている。筆者が会長を務めているデータ管理の専門家の育成機関、米Data Management Instituteの最近の調査によると、現在使われているHDD容量全体の最大70%は、「参照されたり、複製されたりすることがなく、オーファン(所有者がシステムから登録解除されたファイル)でも、アクセス禁止の対象でもない休眠ファイル」を含んでいる。
重複排除のような技術が、ストレージの使用効率の向上に役立つことが明らかになっている。こうした技術は特に、意図していないファイル重複や“ホワイトスペース”(空き領域)による無駄を排除する上で効果的だ。今では多くのファイルシステムが、ファイルシステムレベルでのストレージプロセスの一環として、重複排除を行うように改良されつつある。ただし、当初の取り組みでは、その引き換えにファイルシステムのパフォーマンスが犠牲になっている。
以上のように、現行のファイルシステムを見直す理由はたくさんある。別のデータ保存フレームワークを使うことも選択肢だ。現在、一定の支持を集めている1つのアプローチとして、米Tintriのような企業が開拓しているものがある。これはハイパーバイザーベースコンピューティングの普及に対応し、ディレクトリ、サブディレクトリ、ボリューム、LUN(Logical Unit Number)といった要素を持つ従来のファイルシステムフレームワークを仮想マシンで代替するものだ。
米Caringoなど多くのオブジェクトストレージベンダーが推進しているもう1つのアプローチは、従来のファイルシステムの代わりにオブジェクト指向ストレージフレームワークを使用するもの。このアプローチはクラウドコンピューティングに特に適している。膨大なファイルオブジェクトを含むフラットディレクトリシステムの速度、フィード、容量使用率を改善するからだ。また、このアプローチは、動画や医療画像といったロングブロックファイルにも適している。ロングブロックファイルはあまり頻繁に変更されないが、オブジェクトとその内容の検索に役立つ記述を含むメタデータが付加される可能性がある。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社セールスフォース・ジャパン] 「CRMは設計と無関係」は本当か? PLMとの融合で実現する高速開発 -
事例
[日本ヒューレット・パッカード合同会社] AIエージェントの時代にどう備える? 「新たな働き手」を支える3要素とは -
製品資料
[日本ヒューレット・パッカード合同会社] “横並びの自動化”から脱却、AI活用で生産性と競争力を高める秘訣 -
製品資料
[サイボウズ株式会社] AIが「わざわざ使うツール」になっていない? 業務で自然に使う導線にする秘訣 -
製品資料
[サイボウズ株式会社] 「結局、一部の人しか使わない」 AI活用が業務に定着しない根本的な理由
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
2
法務と開発者で「言葉が通じない」問題 トヨタやソニーが語るOSS管理の真実
-
3
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
4
「Copilot」はなぜ放置される? “議事録要約止まり”を脱する処方箋
-
5
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
6
情報漏えいはなぜ繰り返されるのか 今すぐ見直すべき「境界」
-
7
Microsoft製品でここまで自動化できる 情シスがやめられる手作業10選
-
8
脱VMwareの前提が崩れる BroadcomのVDDK公開停止で確認すべき点
-
9
【基本情報技術者試験】なぜ複数アプリが同時に動く? OSの「マルチタスク」の仕組み
-
10
BMWも導入 78兆円市場に化ける「フィジカルAI」の衝撃
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
家庭用Wi-Fiルーターの業務利用は危険? 避けるべき理由と具体的な対策
-
3
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
4
財務部門がAIを最大限に活用する方法 無駄のない戦略的リーダーシップへの道
-
5
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
6
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
7
なぜRPA導入は頓挫する? シナリオ作成の壁を乗り越える解決策とは
-
8
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
9
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー