




















DWH製品紹介:Netezza(日本アイ・ビー・エム)
高速は当たり前、DWHアプライアンス「Netezza」は「簡単」にこだわり続ける
IBMのビッグデータ戦略の中で重要な役割を担うNetezza。買収以前から一貫してアプライアンス形態で提供しているのには理由がある。
アプライアンスにこだわり続けてきたNetezza
今日、データウェアハウス(DWH)の世界ではアプライアンス製品が高い注目を集めており、各ベンダーが次々新製品を市場に投入しているが、その先鞭をつけたのが2000年に米国マサチューセッツで創業されたNetezzaである。同社は創業当初から一貫してDWHに特化したアプライアンス製品作りを追求しており、2000年代半ばからはそれまで米テラデータの寡占状態にあったDWH市場において、一躍存在感を示すようになった。その後、大小さまざまなベンダーがDWHアプライアンスの開発に乗り出し、現在の活況へと至っている。
ちなみにNetezzaは、2010年11月にIBMに買収されている。しかしNetezzaの製品自体はIBMのポートフォリオに組み込まれた後も、それまでと全く変わらぬコンセプトを踏襲しつつ、さらなる機能強化が進められているという。
日本アイ・ビー・エム ソフトウェア事業 インフォメーション・マネジメント事業部 Netezzaエグゼクティブ 法華津 誠氏は、Netezzaが今日に至るまでひたすらアプライアンスという製品形態にこだわってきた理由を次のように述べる。
「アプライアンスとはもともと『家電』の意味を指す言葉だが、Netezza製品はまさに家電、例えてみれば冷蔵庫のようなもの。設置して電源を入れれば、冷蔵庫が中に格納した食品を冷やし始めるように、Netezzaも内部に格納したデータの活用をすぐに始められる。もちろん、実際には冷蔵庫ほどは簡単にはいかないかもしれないが、イメージとしてはこれにかなり近い」
 法華津氏
ハードウェアとソフトウェアを個別に購入し、それらを組み合わせてDWHシステムを構築するには、通常はかなりの時間とコストを要する。これがアプライアンスであれば、必要なシステム要素があらかじめ全て組み合わされた形で提供されるため、最小限の手間で導入することができる。
またアプライアンスは、稼働開始後の運用管理の面でも一定のメリットがある。一般的なオンラインデータベースシステムで利用されるデータベースソフトウェアとサーバハードウェアは、DWHで頻繁に発生する全件検索などのワークロードに最適化されているわけではない。従って、パーティショニングやインデックスのメンテナンス、集約テーブルの追加といったチューニング作業がどうしても欠かせない。通常はこれに多くの運用工数が割かれることになるのだが、あらかじめDWHのワークロードを想定して一から設計されたアプライアンス製品なら、こうしたチューニングはほぼ不要になる。
ユニークなアーキテクチャでDWHワークロードの高速処理を実現
DWHシステムの優劣を測るための指標として真っ先に挙げられることが多いスループットの面でも、あらかじめDWH特有のワークロードに特化してソフトウェアとハードウェアが設計されているアプライアンスは、オンラインシステム用のソフトウェアとハードウェアを組み合わせたものより一般的に有利だとされる。
この点において、Netezzaの製品は極めてユニークな技術を実装することで、高い処理性能を実現している。それが、「非対称型並列処理」(AMPP:Asymmetric Massively Parallel Processing)と呼ばれるアーキテクチャだ。これは基本的には、複数のノードでクエリ処理を並列分散処理するMPP(超並列プロセッシング)の一種なのだが、通常のMPPとは2つの点で大きく異なる。
1つは、各ノードの上位に単一のホストノードが存在する点だ。一般的には、こうしたホストノードの存在は性能面におけるボトルネックになりやすいと考えられがちだ。しかし、AMPPのホストノードには特別な役割が割り当てられている。
「AMPPの肝は、各ノードの能力を極限まで使い切って高速処理を実現すること。そのために、ユーザーからクエリを受け取ったホストは、配下のノードがなるべく高速に処理できるよう、シンプルな命令の形にクエリを変換し、各ノードに適切に分配する。各ノードは自身でSQLを解釈する必要はなく、ただホストから降りてきた命令をそのまま実行するだけで済むので、余分なオーバーヘッドがなく高速に処理を実行できる」(法華津氏)
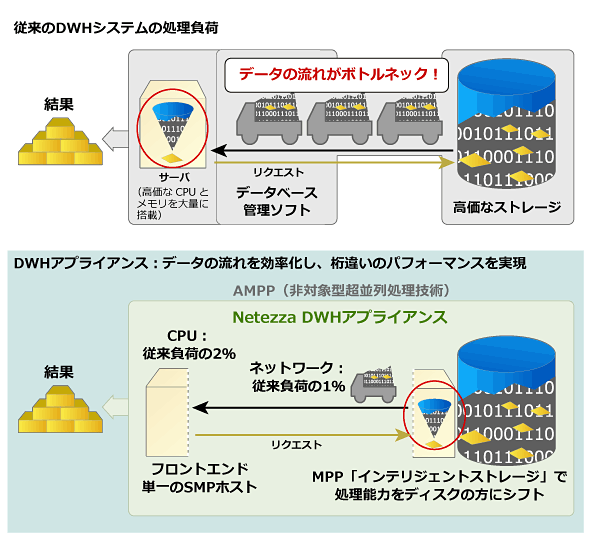 従来のDWHとAMPPを採用したNetezzaのデータ処理の違い
もう1つの特徴的な点は、各ノードの処理をさらに高速化するために、FPGA(Field Programmable Gate Array)を搭載したアクセラレータパーツを装備していることだ。具体的には、ディスクから読み出した圧縮データの展開、列の絞り込み、そして行の絞り込みまでの処理をまずFPGAで行い、そうして絞り込まれたデータがCPUに送られて結合やソート、複雑な計算などが行われる。こうして各ノード内のデータベース処理をストリーミングのイメージで実行することにより、システム全体のさらなる高速化が図られている。
高速であると同時に「簡単」なことがユーザーに評価されている
こう聞くと、Netezza製品はとにかく「速い」ことが売りの製品のように思われるかもしれない。しかし、日本アイ・ビー・エム ソフトウェア事業 インフォメーション・マネジメント事業部 Netezzaマーケティング部 部長 湯本敏久氏によれば、そうした印象は必ずしも正確ではないという。
 湯本氏
「これまでNetezzaの製品はずっと、『高速』『簡単』『低TCO』という3つの特徴を打ち出していたが、実際に製品を利用しているユーザーに話を聞くと、真っ先に高く評価されるのが『簡単』だという点。一般的な製品では、高い性能と運用の簡易性はトレードオフの関係になることが多いので、ここ数年間繰り広げられてきたDWHアプライアンスの性能競争の中で、簡易性を犠牲にしてきたものも多い。しかしNetezza製品は常にトップクラスの性能を誇りながらも、運用の簡易性という特徴は維持してきた。両者をここまで高い次元でバランスさせた製品は、他にはないと思う」
前述したように、チューニング作業がほぼ不要な上、万が一問題が発生してもシンプルなアーキテクチャであるが故に、すぐに問題の切り分けと対処ができるようになっている。そのため、専任の管理者を置くことなく運用しているユーザーも多いという。
さらに、こうした運用の簡単さを、その処理性能の高さと併せて、導入を検討しているユーザーに実際に体感してもらうための無償検証サービスも提供されている。
「ユーザーから見れば、実際に本番環境で本番データを使って、実業務を流して見ないと本当の導入メリット/デメリットは見えてこないはず。従ってわれわれは、当初から一貫して、検討段階でお客さまに無償で製品を試用していただき、必ずその効果を体感し納得していただいてから採用してもらっている」(法華津氏)
アーカイブ用途の大容量アプライアンスも登場
冒頭で紹介した通り、Netezzaは2010年11月にIBMに買収されており、以降はブランド名も「IBM Netezza」と変わっている。製品ポートフォリオとしては、従来の主力製品である「IBM Netezza 1000」(TwinFin)に加え、主に開発・テスト用途で使われる小規模システム向けの「IBM Netezza 100」(Skimmer)、そして大容量のアーカイブ・バックアップ用途向けの「IBM Netezza High Capacity Appliance」(Cruiser)を提供している。
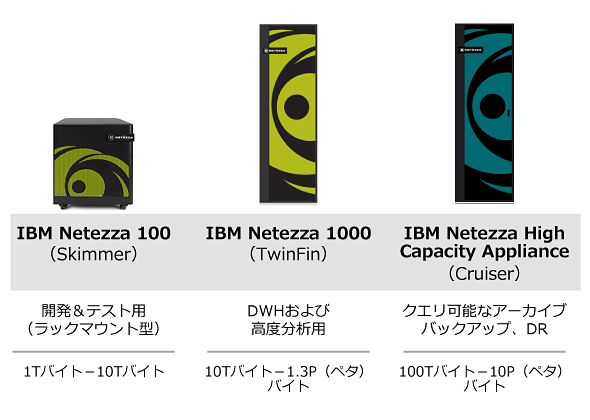 IBM Netezza DWHアプライアンスファミリー
それぞれの製品ごとに、データ容量とノード数が異なるモデルが用意されている。例えばIBM Netezza 1000であれば、4分の1ラックサイズの「IBM Netezza 1000-3」(TwinFin 3)から、10ラックの「IBM Netezza 1000-120」(TwinFin 120)まで、計5モデルが用意されている。規模が大きいモデルになるほどノード数が増えるため、先ほど紹介したAMPPによる分散並列処理の性能が上がり、システム全体の処理性能もリニアに上がっていく。
ちなみにIBM Netezza High Capacity Applianceは、最近ポートフォリオに加わった製品だ。その特徴をごく簡単に表現すれば、「IBM Netezza 1000より容量は大きく、性能は若干劣る」といったところだ。従って、IBM Netezza 1000が分析処理の高速化に主眼を置いているのに対して、IBM Netezza High Capacity Applianceは大容量のアーカイブデータやバックアップデータを管理する用途を前提としている。しかし、単にデータを保管しておくだけであれば、通常のテープバックアップやディスクバックアップで事足りるだろう。あえてIBM Netezza High Capacity Applianceを使うメリットについて、湯本氏は次のように説明する。
「単にテープやディスクにバックアップを取るだけでは、そこからデータをすぐに取り出すことができない。その点、IBM Netezza High Capacity Applianceに保管してあるデータは、いつでもクエリを投げて任意の内容を取り出すことができる、いわゆるアクティブバックアップの状態にある。これは、監査時における査証データの提出といったコンプライアンス上のニーズに応えられる他、最近では災害対策や事業継続の面でのニーズも増えている」
また、IBMの他製品とNetezza製品との連携ソリューションも増えつつある。その1つが、IBM System z上のDB2システムとNetezzaを連携させる「IBM DB2 Analytics Accelerator」だ。これは、IBM System z上で処理される分析系ワークロードの一部をNetezzaにオフロードして高速処理させるというものだ。
「System zのユーザーにとっては分析系処理のスループットが向上するし、トランザクション系処理に及ぼす影響も軽減されるため、システムの使い勝手が向上する。また、IT部門にとってもSystem zの管理が効率化される。ユーザーとIT部門の双方にとって、非常に魅力的なソリューションになると考えている」(法華津氏)
Netezza関連コンテンツ
IBMのビッグデータ戦略の中で重要な役割を担うNetezza
ちなみに、DWHに関連して近年よく耳にするキーワードの1つに、「ビッグデータ」がある。このトレンドが注目されるようになった背景には、ソーシャルメディアデータやセンサーログなど大量の非構造化データを高速処理できる、Hadoopをはじめとした各種オープンソース技術が実用化されてきたことがある。2010年から2011年にかけて、さまざまなベンダーがこうした新技術をベースにしたデータ活用ソリューションを打ち出しており、IBMもいち早くこの取り組みに着手している。
日本アイ・ビー・エム ソフトウェア事業 インフォメーション・マネジメント事業部 マーケティング・マネジャー 中林紀彦氏は、ビッグデータの特徴を次のように説明する。
 中林氏
「一般にビッグデータというとデータ量と捉えがちだが、ビッグデータの特性として3つの『V』がある。まず、過去に例を見ないほどの大容量であること(Volume:量)。次に音声や画像、チャットのテキストなど多様なデータが増えてきたこと(Variety:種類)。3つ目にモノそのものがインターネット上でつながり、リアルタイムで情報収集、分析処理が可能になったこと(Velocity:頻度)。データ量だけではなくデータの種類(Variety)と生成頻度(Velocity) という特性も合わせて対応し、企業経営に生かしていくことが重要だ」(中林氏)
同社では現在、この3つの「V」に対応するためのエンジンとして、Hadoopベースの並列分散処理エンジン「IBM InfoSphere BigInsights」と、ストリーミングによるリアルタイムデータ処理基盤「IBM InfoSphere Streams」という2つのビッグデータ関連ソリューションに、Netezza製品を加えた3つをビッグデータソリューションのコア技術に据えている。これら3つそれぞれの位置付けについて、中林氏は次のように説明する。
「IBM InfoSphere Streamsは、ストリーミングによるリアルタイムデータ処理に特化した製品で、他社のアーキテクチャとの大きな違いは『データをためないこと』にある。メモリ上のデータベースに格納して処理するよりも桁違いの高速処理を可能にしている。一方、分析用途などのために大量データをバッチ処理する場合には、対象データが非構造化データの場合はIBM InfoSphere BigInsights、そして構造化データの場合はNetezzaが適する」
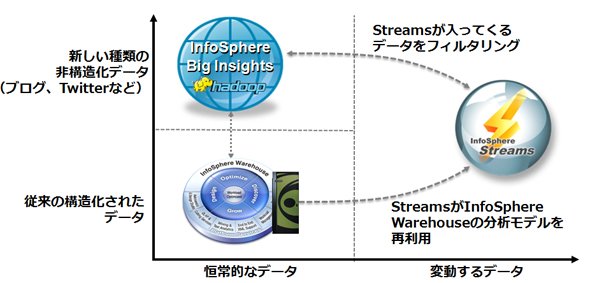 ビッグデータに対するIBMのアプローチ。「Hadoopだけではビッグデータの課題は解決できない。3つの「V」に対応するためには3つをつなげて連携させることが必要」(中林氏)
このように、データやワークロードの性質によってそれぞれプラットフォーム技術を使い分けていくことが、IBMが提案するビッグデータ活用のベストプラクティスなのだという。
「他社が掲げるビッグデータソリューションの中には、単一プラットフォームでこれら全てのワークロードをカバーするというものもあるが、それではどうしても最小公倍数のスペックが必要になり、無駄なリソースが生じてしまう。そうではなくて、それぞれに最適なプラットフォームを使い分けつつ、同時に互いをうまく連携させることで、あらゆる種類のデータから新たな価値を見いだしていくことができるのが、IBMのビッグデータソリューションの強みだ」(中林氏)
Netezza製品は今後IBMのデータ活用ソリューションの中で極めて重要な役割を担うが、かといってIBM以外のベンダーの製品との連携が途絶えてしまうということではない。
「Netezzaの製品はこれまで、幅広いサードパーティー製のビジネスインテリジェンス(BI)ツールやETLアプリケーションとの連携をサポートしてきた。もちろん、IBMと一緒になったことでIBM製品との連携はこれまで以上に強化していくが、他製品との連携もこれまで通りサポートし、製品のオープン性を維持していく」(法華津氏)
Copyright © ITmedia, Inc. All Rights Reserved.


新着ホワイトペーパー PR
-
事例
[日本オラクル株式会社] ピンチをチャンスに変えたEPR製品は? 先行企業の導入事例3選 -
技術文書・技術解説
[日本オラクル株式会社] 無自覚なリスク 秘伝Excelファイルが監査の壁、不正・ミスの温床となる理由 -
製品資料
[日本オラクル株式会社] 戦略的経理の第一歩 失敗のない「脱Excel」を実現する秘訣とは? -
技術文書・技術解説
[日本オラクル株式会社] いまさら聞けないオンプレERPとクラウドERPの違い 最適な製品をどう見極める? -
事例
[株式会社ビザスク] 連結売上高が約2倍に成長、富士フイルムが実践した新規事業創出の戦略とは?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
損保ジャパンはなぜ「COBOL」を捨てなかったのか? 脱メインフレームの真相
-
2
なぜ「全社配布Copilot」は使われないのか? 失敗に学ぶAI定着
-
3
「0.3秒のスピード顔認証」の入退室管理が社員に好評 事例に学ぶオフィス改革
-
4
「ノートPC派」は損をしている? Dellと考える“自作PC”のメリット
-
5
エンジニアの生産性はどう測る? マネジメントに不可欠な可視化の実現方法とは
-
6
慶應義塾が「Notion」を選んだ理由 AI導入の盲点になる“情報のサイロ化”
-
7
LINEヤフーはなぜ「社内の管理者」すら信用しないインフラを作ったのか
-
8
1200万円のSaaS導入を回避 スギ薬局「運用費10万円」のAIエージェント構築術
-
9
「また同じ説明か」 消費者の半数が離脱するAIチャットbotの“記憶喪失”
-
10
「Copilot」はなぜ放置される? “議事録要約止まり”を脱する処方箋
ホワイトペーパーランキング PR
-
1
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
2
DX/AI投資の壁を突破、現代の最高財務責任者が直面する課題と克服のヒント
-
3
「オンプレミス回帰」せざるを得ない“合理的な理由”
-
4
LLMが兵器化? 元FBI高官が鳴らす警鐘とセキュリティツール統合のポイント
-
5
システムの保守がモダン化を阻む? 「変えない判断」から脱却する方法とは
-
6
生成AIを開発に導入しても効果が見えない? 実証実験で分かった成果と課題
-
7
経産省DX指針から読み解く、受発注業務デジタル化ロードマップ
-
8
“あのファイル転送”で暗躍するノーウェアランサム
-
9
Microsoft 365を安全に運用 うっかりミスやサイバー攻撃に備えるデータ保護術
-
10
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー