





















押さえておきたいSQL ServerとHadoop連係の注意点【前編】
SQL ServerユーザーのためのHadoop連係入門
SQL ServerとHadoopの連係でビッグデータ分野に乗り出したMicrosoft。しかしSQL Server用のHadoopコネクタは、SQL Serverのユーザーには取っつきにくいかもしれない。
米Microsoftが「ビッグデータ」の領域に進出する動きを見せている。同社が狙っているのは、米Googleや米Yahoo!などの企業が創業当初から取り組んでいる膨大な非構造化データの分野だ。例えばGoogleでは、毎日20P(ペタ)バイト(2万Tバイト)のデータを処理しており、その大部分はテキストベースのインデックスファイルの形式だ。しかしビッグデータの種類はインデックスだけではない。企業では大量の電子メール、文書、Webサーバのログ、ソーシャルネットワーキングフィード、その他の各種の非構造化情報を日常的に管理している。
GoogleやYahoo!に加え、米Autodesk、米IBM、米Facebookなどの企業では、大量のデータを管理するためにApache Hadoopを採用している。Hadoopは、従来型のツールでは処理できない膨大な非構造化データを管理するためのオープンソースクラウドプラットフォームだ。Hadoopの人気に目を付けたMicrosoftは、自社のSQL ServerとHadoopを接続する技術を開発した(関連記事:マイクロソフトのビッグデータ対応、明かされたSQL Server 2012の新機能)。
Microsoftが最近リリースしたコネクタは、HadoopクラスタとSQL Server 2008 R2やParallel Data Warehouse、あるいは開発中のSQL Server 2012(コードネーム:Denali)との間で大量のデータを移動することを可能にする。これらのコネクタではデータを双方向に移動できるため、SQL Serverのストレージ機能とデータ処理機能を生かしながら、大量の非構造化データを管理するHadoopの機能を利用することが可能だ。
しかしSQL Server用のHadoopコネクタは、SQL Serverのユーザーには取っつきにくいかもしれない。これらはLinux環境に実装されるコマンドライン型ツールなのだ。このため、同コネクタの導入を計画しているSQL Serverユーザーは、それがHadoop環境とどう連係するのかを概念的に把握しておくことが大切だ。
Apache Hadoopクラスタ
HadoopはLinuxコンピュータ上に実装されるマスター/スレーブ型アーキテクチャだ。膨大なデータを処理するには、Hadoop環境に以下のコンポーネントを含める必要がある。
マスターノード
スレーブノードを管理する。データファイルの処理、管理、アクセスに関連したタスクも管理する。さらにマスターノードは、ジョブリクエストをHadoop環境に送信する外部アプリケーションのための一次アクセスポイントとしての役割も果たす。マスターノードはマスターサーバと呼ばれることもある。
ネームノード
ネームノードデーモンを実行する。ネームノードデーモンはHadoop Distributed File System(HDFS)名前空間を管理し、データファイルへのアクセスを制御する。ネームノードはファイルのオープン、クローズ、リネームをサポートする他、データブロックをスレーブノードにどのようにマッピングするかを決定する。小規模な環境であれば、マスターノードと同じサーバ上にネームノードを実装することも可能だ。
スレーブノード
各スレーブノードはデータノードデーモンを実行する。データノードデーモンはデータファイルの保存を管理し、データファイルに対するリード/ライトリクエストを処理する。スレーブノードは比較的低価格で入手が容易なコモディティハードウェアで構成されるので、数千台のコンピュータ上で並列処理を実行することが可能だ。
各種のコンポーネントがHadoop環境内でどのように連係動作するかを図1に示す。マスターノードはジョブトラッカーデーモンを実行し、各スレーブノードはタスクトラッカーデーモンを実行する。ジョブトラッカーはクライアントアプリケーションからのリクエストを処理し、これらのタスクをタスクトラッカーの各インスタンスに割り当てる。タスクトラッカーはジョブトラッカーから指示を受け取ると、データノードと連係して割り当てられたタスクを実行し、処理の各段階でデータの移動を管理する。
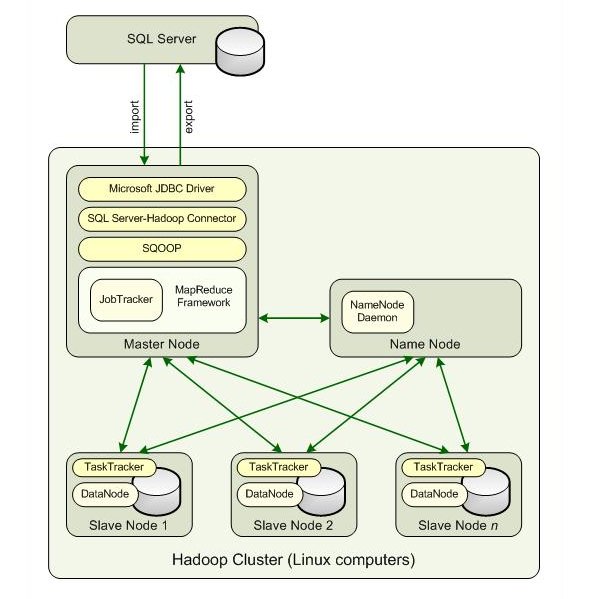 図1:Hadoopクラスタ内にSQL Server用のHadoopコネクタを実装しなければならない
MapReduceフレームワーク
図1に示すように、マスターノードはMapReduce処理を実行するのに必要なフレームワークをサポートする。MapReduce技術はHadoop環境のコア部分に位置する。むしろ、HadoopはMapReduceフレームワークであると見なすこともできる。このフレームワークでは、ジョブトラッカーやタスクトラッカーなどのコンポーネントが重要な役割を果たす。
MapReduceは巨大なデータセットを、管理しやすい小さなチャンク(塊)に分割し、何千台ものコンピュータに分散できるようにする。大規模な並列処理、何P(ペタ)バイトものデータの検索、複雑なクライアントリクエストの管理、掘り下げたデータ分析の実行などに必要なメカニズムも提供する。さらにMapReduce構造は、処理を正確かつ素早く完了するのに必要なロードバランシングとフォールトトレランスも備える。
MapReduceフレームワークは、各ファイルを一連のブロックに保存するHDFSフレームワークと連係して動作する。各ブロックはフォールトトレランスを実現するためにクラスタ内で複製される。1つのファイルを構成するブロックは、最後のブロックを除けば全て同じサイズだ。各スレーブ上のデータノードデーモンは、HDFSと連係してブロックの作成、消去、複製を行う。しかしHDFSファイルは、一度に1つのアプリケーションが1回しか書き込めない。
以上を踏まえ、後編ではSQL Server用のHadoopコネクタの実装手順について解説する。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

新着ホワイトペーパー PR
-
技術文書・技術解説
[ネットアップ合同会社] 金融庁ガイドラインから読み解く、「次世代データレジリエンス」の在り方 -
製品資料
[ネットアップ合同会社] 製造DXでデータ活用ニーズが拡大 分散データ活用とAI活用をどう実践する? -
製品レビュー
[ネットアップ合同会社] AIで使いたいデータが内外に点在、研究におけるAI活用を阻む“真の課題”とは -
製品資料
[株式会社kickflow] 稟議・承認作業の「脱オンプレ・脱Excel・ペーパーレス化」を一気に進める方法 -
製品レビュー
[株式会社kickflow] ワークフローシステムのクラウド化 “みんなが不幸になる”事態を避けるには?
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
なぜ人はいるのにDXが進まない? ライオンも直面した“老害”レガシーシステム
-
2
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
3
障害対応に「余裕なし」が9割超 運用担当316人調査で見えた「運用赤字」
-
4
シャトレーゼを悩ませる偽メール 混乱なしでBIMI導入とDMARC強化を実現した方法
-
5
「エージェントを作るな、スキルを作れ?」 Anthropicが提唱するAI運用の勘所
-
6
Microsoft月例パッチ1400件超で過去最多 「限界点」を迎えたパッチ管理
-
7
PHP脆弱性「PHP2Shell」で2260万件に影響 情シスの緊急チェックリスト
-
8
いまIBM iエンジニアが直面する「5つの技術的課題」とその解決策
-
9
「ITサービスマネジメントの利用実態」に関するアンケート
-
10
「年1回の外部診断」が限界に 大手小売が脆弱性管理を内製化・一元化した方法
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
2026年のサイバーセキュリティには何が必要か? 最新データに学ぶ傾向と対策
-
3
経験豊富な即戦力人材に直接アプローチできる、「攻めの採用」への転換術
-
4
「IT史に名を残すシステム障害」8選
-
5
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
6
10G回線の真価をフルに享受するには? 導入前にチェックしたいポイント
-
7
AI駆動開発のスピードと安全性を両立 「品質・セキュリティ管理」の実践ガイド
-
8
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
-
9
「標的型攻撃メール」事例・サンプル集
-
10
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー