





















ビッグデータクラスタやPolyBaseなども強化
徹底解説:SQL Server 2019で追加・強化された驚きの機能とは(1/2 ページ)
Microsoftは「SQL Server 2016」と「SQL Server 2017」をリリースした直後から、既に「SQL Server 2019」を発売する準備をしていた。そのため、同社は驚くほど多くの新機能を短期間で追加している。
 ビッグデータとの親和性も加速?
Microsoftの「SQL Server 2019」には、ビッグデータ統合の新機能、データベースエンジンの機能強化、Linuxとコンテナのサポート強化が含まれている。
ビッグデータ統合とその強化はSQL Server 2019をリリースする目的の1つだ。本稿執筆時点では、このリリースをプレビューモードで利用できる。「ビッグデータクラスタ機能」のおかげで、あらゆる場所のデータに対してクエリを実行できるようになった。その結果、利用できるプラットフォームが増加し、ビッグデータシステムとの統合を強化できる。
併せて読みたいお薦め記事
SQL Server 2019について
SQL Server on Linuxについて
- Linux版「Exchange」の開発はあるか、「SQL Server on Linux」登場で高まる期待
- SQL Server on Linuxプレビュー版公開で探るMicorosoft“オープン化”の本気度
いまさら聞けない「ビッグデータ分析」とは
それだけではない。SQL Server 2019のリレーショナルデータベース(RDB)エンジンには、パフォーマンスの向上とセキュリティの改善を実現する強化が多数加えられている。MicrosoftはWindowsで動作するSQL Serverと同等の機能を利用できるよう「SQL Server on Linux」の強化も続けている。
では、今後予定されているSQL Server 2019リリースの最も重要な新機能の一部を詳しく見ていこう。
ビッグデータクラスタで可能になるデータ仮想化
SQL Serverのビッグデータクラスタ機能により、ビッグデータソースとの密接な統合が可能になった。その結果、新たにデータ仮想化機能が利用できる。SQL Server 2019のビッグデータクラスタは「PolyBase機能」を活用することでデータ仮想化を実現する。データ仮想化とは、データの移動やコピーをせずに多数のソースのデータを組み合わせることを指す。
昨今の企業は一般的に、リレーショナルと非リレーショナルを組み合わせたさまざまな種類のデータを使用している。このため通常はリレーショナルデータソースと非リレーショナル(ここではビッグデータソースの意味)の両方のデータを組み合わせる必要がある。最も価値の高い企業データはSQL Serverのようなリレーショナルデータベースに保存する。IoTデータのようなビッグデータソースは主に「Hadoop Distributed File System」(HDFS)などの分散ファイルシステムに保存する。
この2種類のデータの組み合わせが求められることは多い。Extract(抽出)、Transform(変換)、Load(読み込み)というプロセス(ETLプロセス)を用いて、単一のプラットフォームにデータをコピーし、そこでレポートや分析を実行するのが一般的だ。こうしたプロセスはバッチ処理指向であるため、実行に時間がかかり、大量のストレージが必要になる。
SQL Server 2019のビッグデータクラスタには、PolyBase機能がある。この機能を使ってデータのレプリケート(複写)や移動なしで複数のデータソースのデータをまとめる。価値の高いリレーショナルデータとビッグデータを1つのクエリで組み合わせるのが基本だ。その際に、ETLプロセスを実行したり余計なストレージを使用したりする必要はない。この仕組みを実現するために、SQL Server 2019のデータベースエンジンはHDFSファイルをネイティブに読み取れるようになっている。
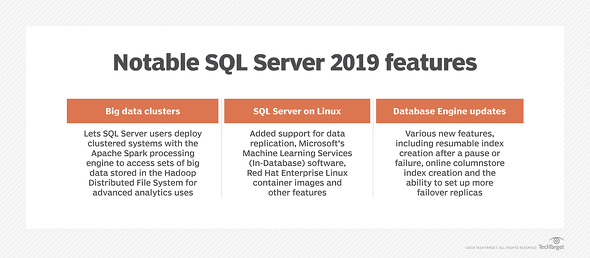 図1 SQL Server 2019で最も期待される3つの分野の新機能
SQL Server 2019のビッグデータクラスタは多数の異なるテクノロジーをベースに構築されている。例えば、「Docker」(SQL Server on Linuxで利用)「Apache Spark」「Apache Hadoop」「Kubernetes」などがベースになる。SQL Server 2019のビッグデータクラスタを使用することで、ユーザーはSQL Serverコンテナで構成されたスケーラブル(拡張可能)なクラスタをKubernetesに導入できる。これらのコンテナでは「Transact-SQL」を使用してビッグデータの読み取り、書き込み、処理ができる。
SQL Server 2019のビッグデータクラスタの大まかな概要を図2に示す。この図から、ビッグデータクラスタがSQL ServerコンテナとSpark Linuxコンテナから構成され、コンテナ管理とオーケストレーションにKubernetesが使われていることが分かるだろう。Dockerコンテナはコンピューティング層を構成するノードのグループ上で実行され、クエリはこれらの複数のDockerコンテナ全体で並列処理される。高度な分析や機械学習はSparkを使って実行可能だ。ビッグデータクラスタのアクティビティーはSQL Serverの「マスターインスタンス」が管理する。
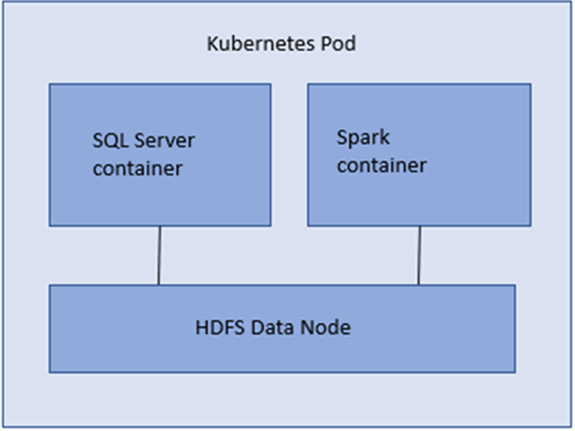 図2 SQL Server 2019のビッグデータクラスタの大まかな概要
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
新着ホワイトペーパー PR
-
製品資料
[株式会社うるる] 「入札市場」攻略ガイド:効率的に落札するためのポイントを徹底解説 -
製品資料
[株式会社うるる] 入札情報に特化した「販路拡大」「効率化」のためのサポートツールとは? -
市場調査・トレンド
[株式会社うるる] 公共入札に成功する企業と失敗する企業の「5つの違い」 -
製品資料
[日本ビジネスシステムズ株式会社] 専門家が教える、Microsoft 365の「テナント統合/分離」を成功に導く秘訣 -
製品資料
[rakumo株式会社] Microsoft 365での情報埋没を防ぐ、社内ナレッジを資産化する情報ポータル活用
こんなメディアも見られています
TechTargetジャパンに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




ベンダーコンテンツ PR
From Informa TechTarget
SpecialPR
アクセスランキング
-
1
PHP脆弱性「PHP2Shell」で2260万件に影響 情シスの緊急チェックリスト
-
2
Claude利用8割のGMO、AI人材の評価軸が「トークン管理」に変わった
-
3
「Microsoft 365」が乗っ取られる MFAを破る“本物の画面”の恐怖
-
4
「テザリング依存」に潜む落とし穴 “遅いVPN”を解消するネット構築術
-
5
なぜ「Gemini 4 Argon」は出遅れたのか? Googleが狙う“逆転のシナリオ”
-
6
「IT運用・情報システム業務」に関するアンケート
-
7
「Windows」の不要なファイルを安全に消して容量を空ける方法
-
8
半数がブルーカラー転向を視野に? ベテランエンジニアを追い込む“54歳の壁”
-
9
ChatGPTは“検索しまくり”でGeminiは“淡泊”? データが明かすAIの裏側
-
10
被害額は過去最高額 それでも「サイバー犯罪者が捕まらない」3つの理由
ホワイトペーパーランキング PR
-
1
AI駆動攻撃にどう対抗する? 超速の攻撃からエンドポイントを保護する方法
-
2
2026年のサイバーセキュリティには何が必要か? 最新データに学ぶ傾向と対策
-
3
経験豊富な即戦力人材に直接アプローチできる、「攻めの採用」への転換術
-
4
「IT史に名を残すシステム障害」8選
-
5
最速72分でデータが流出? 最新の脅威トレンドや侵入手法から分かった防衛策
-
6
不審メールの経路や見せ方に変化? 2026年夏の3事例から見えた動向と対処方法
-
7
AI駆動開発のスピードと安全性を両立 「品質・セキュリティ管理」の実践ガイド
-
8
HDDを使わない「SSDオンリー」が無謀なのはなぜ?
-
9
「標的型攻撃メール」事例・サンプル集
-
10
Microsoft 365のメールセキュリティ、3つの“死角”と追加で検討すべき対策とは
TechTargetジャパン SNS
 @techtarget_itmをフォロー
インフォメーション
注目情報をチェック
TechTargetジャパンをフォロー